Collegare le previsioni dei peptidi ML a sequenze pronte per il laboratorio: Lezioni da modelli di grandi dimensioni e studi di progettazione
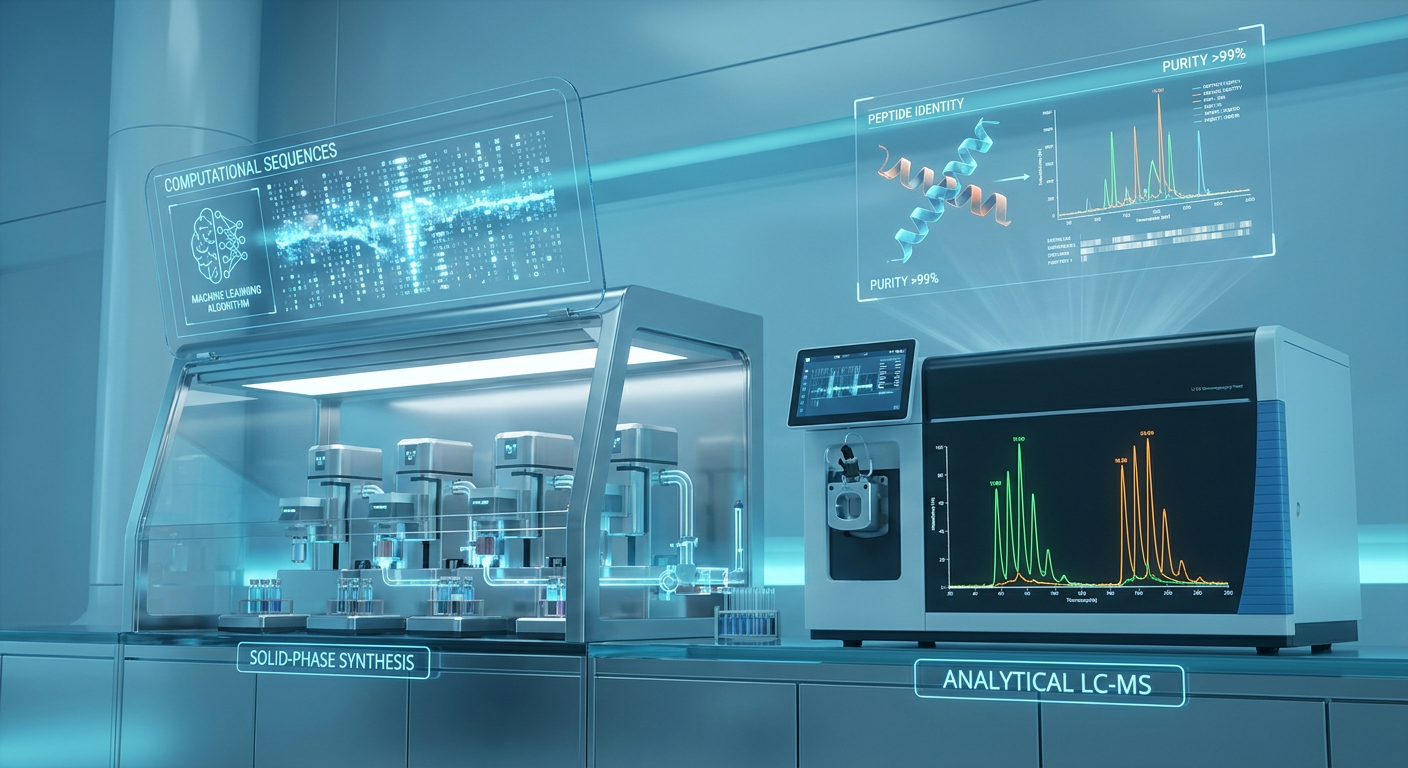
Intelligenza artificiale generativa, algoritmi di diffusione, e modelli linguistici di grandi dimensioni hanno alterato la traiettoria della scoperta dei peptidi. Le piattaforme computazionali possono valutare miliardi di sequenze candidate in poche ore, assegnare un punteggio ai candidati per l’affinità di legame, selettività del recettore, e struttura secondaria prevista. Tuttavia, i team di ricerca riscontrano spesso un forte calo dei tassi di successo durante la transizione dai test in silico ai test fisici in laboratorio umido. Un peptide ottimizzato computazionalmente che ottiene il punteggio massimo 0.1% di uno schermo virtuale potrebbe fallire completamente durante la sintesi del peptide in fase solida (SPSS), aggregato durante la scissione del TFA, o formare complessi colloidali che producono segnali falsi positivi nei test di screening.
Tradurre le previsioni del machine learning in soluzioni verificabili, i peptidi ad elevata purezza richiedono un quadro di triage di sequenza consapevole sperimentalmente. Piuttosto che trattare i risultati computazionali come candidati finali, i principali team di scoperta applicano un filtro di producibilità secondario che valuta i limiti di assemblaggio fisico, introduce chimiche di modificazione prevedibili, e sottopone i candidati a una pipeline di convalida ortogonale a 4 livelli prima di investire in test biologici approfonditi.
Perché i modelli di machine learning generano errori nel Wet-Lab
La maggior parte dei modelli di deep learning per la progettazione dei peptidi operano in uno spazio energetico o strutturale ideale. Gli algoritmi addestrati su strutture co-cristalline PDB statiche o dati di affinità ottimizzano l'energia di interazione target, complementarità elettrostatica, e stabilità del diedro della spina dorsale. Tuttavia, questi modelli raramente incorporano la fisica chimica dell'allungamento graduale della catena peptidica su un supporto solido.
Quando un modello computazionale genera una sequenza di 20 o 30 metri ricca di residui idrofobici, Motivi di promozione del foglio β, o catene laterali ingombranti, trascura la meccanica fisica dell'assemblaggio del peptide. Durante la sintesi del peptide in fase solida Fmoc, man mano che la catena peptidica in crescita raggiunge 8 A 15 aminoacidi in lunghezza, Il legame idrogeno intercatena e intracatena può indurre la formazione di struttura secondaria del foglio β direttamente sulla matrice resinosa. Questo fenomeno, noto come aggregazione di resina, limita il rigonfiamento del solvente e protegge l'ammina N-terminale dagli amminoacidi attivati in entrata.
Chiave da asporto: Punteggi di legame computazionale elevati non garantiscono la sintetizzabilità fisica. I risultati del machine learning non filtrati spesso concentrano residui idrofobici e che promuovono il foglio β che causano una grave aggregazione della resina, accoppiamento incompleto, e impurità troncate durante la sintesi in fase solida.
L'aggregazione della resina porta a due principali modalità di guasto nell'esecuzione in laboratorio umido:
- Deprotezione Fmoc incompleta: L'aggregazione intercatena limita l'accesso della piperidina al gruppo Fmoc N-terminale. Nella sintesi del flusso, questo si manifesta come profili di deprotezione UV appiattiti e allargati. Nella sintesi batch, deprotezione incompleta foglie troncate, Protetto Fmoc, o prodotti collaterali acetilati che sono difficili da separare dal peptide bersaglio mediante HPLC preparativa in fase inversa.
- Attenuazione dell'accoppiamento e intralcio sterico: Residui adiacenti voluminosi o densi di carica (come l'Arg consecutivo, Con, Val, o gruppi Leu) creare una congestione sterica locale. Test di accoppiamento colorimetrico standard, tra cui ninidrina e TNBS, spesso danno risultati falsi negativi una volta che si verifica un grave collasso della resina, nascondendo le catene non reagite finché la spettrometria di massa non rivela ampie sequenze di delezione.
Filtri di producibilità in sequenza quantitativa
Per evitare che sequenze senza uscita entrino nella pipeline di sintesi, i risultati computazionali devono passare attraverso filtri di triage quantitativi prima che inizi la sintesi chimica.
Generazione di candidati (In Silico) → Producibilità & Screening dell'aggregazione → Modificazione chimica & Strategia di protezione → Assemblaggio SPPS fisico → QC biofisico a più livelli
1. Deprotezione Fmoc in linea & Metriche di aggregazione delle soluzioni
Lo screening della sintetizzabilità combina tracce storiche di sintesi del flusso con regole di chimica fisica. Due parametri chiave quantificano il rischio di aggregazione:
- Fattore di aggregazione (DI): Derivato dall'assorbimento UV in linea durante la rimozione del Fmoc nella sintesi a flusso, definito come la differenza tra la larghezza del picco di deprotezione e la sua altezza (AF = Wₙ – Hₙ). Sequenze che mostrano un AF > 20 o ampliamento del picco di deprotezione maggiore di 20% rispetto ai cicli iniziali comportano un grave rischio di sintesi. Come dimostrato in lo studio di Nature Chemistry sull'aggregazione della sintesi peptidica (2026), la composizione della sequenza e il clustering idrofobico guidano queste anomalie di deprotezione.
- Indice di aggregazione (AI): Valuta l'assemblaggio colloidale allo stato di soluzione utilizzando la spettrofotometria UV su due lunghezze d'onda: AI = (La₃₅₀/La₂₈₀ – La₃₅₀) × 100 Un'intelligenza artificiale qui sotto 3 indica un chiaro, soluzione monomerica. Un'intelligenza artificiale in mezzo 3 E 30 riflette la leggera oligomerizzazione, mentre un'intelligenza artificiale sopra 30 indica una forte aggregazione colloidale che interferirà con la cromatografia liquida e i test biologici.
2. Idropatia, Carica, e tendenza strutturale
La composizione della sequenza determina sia la fattibilità dell'SPPS che la solubilità in acqua:
- SUGO DI CARNE (Grande media di idropatia): Sequenze con un punteggio GRAVY maggiore di +0.4 sono altamente idrofobi e soggetti a precipitazione durante la purificazione HPLC.
- Triadi idrofobiche: Amminoacidi idrofobici consecutivi (per esempio., Scelta-Scelta-Scelta, Phe-Ile-Leu, Trp-Trp-Val) innescare una rapida aggregazione del foglio β durante la SPPS. Inserimento di residui carichi (Lys, Arg, Glu) oppure gli amminoacidi che alterano la struttura riducono questa tendenza.
- Punto isoelettrico (pi) Allineamento: Peptidi con un pI vicino al pH del tampone fisiologico (pH 7,0–7,4) spesso mostrano una scarsa solubilità durante i test cellulari.
3. Instabilità chimica e motivi di reazione laterale
I progetti computazionali devono essere controllati per gli accoppiamenti di amminoacidi reattivi che subiscono una degradazione spontanea durante la sintesi, scollatura, o deposito:
- Scollatura Asp-Pro: Legami dipeptidici acido-labili che subiscono una rapida autolisi durante lo standard 95% Scissione del TFA.
- Formazione di aspartimide Asn-Gly e Asp-Gly: La chiusura dell'anello in condizioni basiche di deprotezione della piperidina produce intermedi succinimmidi, risultante in α- e prodotti collaterali β-aspartilico.
- Ossidazione di Met e Trp: I residui di metionina si ossidano facilmente in solfossidi, mentre il triptofano forma prodotti collaterali t-butilati o polimerici durante la scissione del TFA se si tratta di cocktail scavenger (per esempio., EDT, tioanisolo, acqua, fenolo) sono bilanciati in modo errato.
- Ciclizzazione Gln N-terminale: Glutammina in posizione 1 ciclizza spontaneamente in piroglutammato in condizioni di conservazione acide o neutre.
Matrice di triage di producibilità quantitativa
| Metrico / Caratteristica | Intervallo target ideale | Borderline (Richiede aiuti chimici) | Soglia di rifiuto ad alto rischio | Conseguenza del laboratorio umido |
|---|---|---|---|---|
| Lunghezza (Residui) | 5 – 25 amminoacidi | 26 – 40 amminoacidi | > 45 amminoacidi | Calo esponenziale della resa del greggio; alto tasso di troncamento |
| Punteggio SUGO | -0.8 A +0.2 | +0.2 A +0.5 | > +0.5 | Grave insolubilità acquosa; fallimento della depurazione |
| Fattore di aggregazione (DI) | < 10 | 10 – 20 | > 20 | Picchi di deprotezione Fmoc appiattiti; amminoacidi non reagiti |
| Punto isoelettrico (pi) | < 5.5 O > 8.5 | 5.8 – 6.5 O 7.8 – 8.2 | 6.8 – 7.5 | Precipitazione isoelettrica in tamponi fisiologici |
| Contenuto Cys | 0 – 2 residui | 3 – 4 residui (controllato) | > 4 Cys non accoppiato Sintesi peptidica | Ponti disolfuro errati; oligomerizzazione ossidativa |
| Incontro non protetto / Trp | 0 residui | 1 residui (è richiesto lo spazzino) | ≥ 2 residui | Rapida ossidazione e formazione di addotti durante la scissione del TFA |
Pronostico in silico vs. Realtà fisica del laboratorio umido
<tFocus sull'ottimizzazione in silico Fornitore di peptidi di codice“>Dominio delle funzionalità
Focus sull'ottimizzazione in silico
Vincolo fisico del laboratorio umido / Modalità di fallimento
Strategia pratica di mitigazione
<Utilizza resine PEG a bassa sostituzione e additivi caotropici (LiCl/DMF) Peptide Ch(Arg, Con, Val)
| Struttura secondaria | Massimizza l'α-elica / Stabilità del foglio β nel sito di legame target | Aggregazione di fogli β intercatena direttamente su supporto in resina | Inserire dipeptidi pseudoprolina o gruppi protettivi della spina dorsale (Dmb/Hmb) |
| Idrofobicità residua | Contiene nuclei idrofobici per un'elevata affinità di legame | Bassa solubilità in acqua, Precipitazione HPLC, e incrostazione della colonna | Distribuzione degli oneri di equilibrio; incorporano tag solubilizzanti polari |
| Allungamento della catena | Presuppone l'addizione di sequenze lineari senza barriera sterica | Utilizza resine PEG a bassa sostituzione e additivi caotropici (LiCl/DMF) | |
| Venditore di peptidi Affinità di destinazione | Punteggi ΔG e cinetica di legame nello stato monomerico ideale | Autoassemblaggio colloidale non specifico che causa legami promiscui | Convalidare la monodispersità dello stato della soluzione tramite DLS (PdI <0.15) & SEC-MALS |
Chimiche di modificazione prevedibili e aiuti sintetici
Quando una sequenza computazionalmente promettente mostra una producibilità borderline, i ricercatori non hanno bisogno di scartare del tutto il risultato. La biologia chimica offre interventi strutturali che interrompono temporaneamente la struttura secondaria durante la SPPS o stabilizzano la sequenza per la gestione in laboratorio.
1. Dipeptidi della pseudoprolina e gruppi protettivi della spina dorsale
Per prevenire l'aggregazione della resina durante l'allungamento della catena, Sono tornato per presentare i chimici di sintesi
Dipeptidi pseudoprolinici: Incorporando derivati ossazolidinici della serina o della treonina, come Fmoc-Xaa-Thr(Ψᵐᵉ˒ᵐᵉpro)-OH o Fmoc-Xaa-Ser(Ψᵐᵉ˒ᵐᵉpro)-OH: introduce una conformazione cis nel legame peptidico. Questo nodo agisce come un interruttore del foglio β durante la SPPS, preservando il rigonfiamento della resina. Dopo la scissione finale del TFA, l'anello ossazolidinico si apre quantitativamente per produrre Ser o Thr nativi. Peptide
n scissione finale del TFA, l'anello ossazolidinico si apre quantitativamente per produrre Ser o Thr nativi.
- Protezione della dorsale N-Dmb e N-Hmb: Derivati come N-(2,4-dimetossibenzile) (Dmb) o N-(2-idrossi-4-metossibenzile) (Hmb) sostituire i protoni ammidici lungo la spina dorsale, eliminando la rete di legami idrogeno intercatena che guida l’aggregazione.
Per Suggerimento: Quando si sintetizzano progetti computazionali più lunghi di 20 residui contenenti domini idrofobici, pianificare in anticipo l'inserimento di dipeptidi di pseudoprolina nelle posizioni native Xaa-Ser o Xaa-Thr. Questa singola modifica può trasformare una sequenza completamente non accoppiabile in una sintesi ad alto rendimento.
</co
Ghp Peptide Company Intervento con la pseudoprolina
rowspan="1">
Articolo
| Dettaglio | |
|---|---|
| Sequenza di aggregazione nativa | H-Leu-Val-Val-Ile-Thr-Leu-Val-Gly-OH (Alta aggregazione di resina) |
| Intervento con la pseudoprolina | H-Leu-Val-Val-Ile-[Thr(Ψᵐᵉ˒ᵐᵉpro)]-Leu-Val-Gly-OH (Struttura del foglio β interrotta) |
| Prodotto di scissione post-TFA | H-Leu-Val-Val-Ile-Thr-Leu-Val-Gly-OH (Sequenza target nativa) |
2. Architettura della resina e ottimizzazione del sistema solvente
Adattare il supporto fisico alle caratteristiche della sequenza è vitale per i peptidi difficili:
- Resine PEG a bassa sostituzione: Resine polistireniche tradizionali ad alta sostituibilità (0.6–1,0 mmol/g) causare una rapida congestione sterica per peptidi lunghi o strutturati. Passaggio a supporti a base di glicole polietilenico (per esempio., TentaGel, NovaPEG, PEGA) con bassi tassi di sostituzione (0.15–0,25 mmol/g) aumenta il volume di rigonfiamento della resina e mantiene l'accesso aperto ai siti di accoppiamento.
- Additivi caotropici e solventi misti: Aggiunta di sali caotropici come LiCl (0.8 M nel DMF) o sostituendo il DMF standard con l'NMP, DMA, o miscele binarie contenenti DMSO interrompono gli aggregati non covalenti durante le fasi di accoppiamento difficili.
3. Coniugazione e ciclizzazione bio-ortogonale
Le modifiche dovrebbero basarsi su prevedibilità, sostanze chimiche ad alto rendimento che evitano reazioni collaterali non specifiche:
- Fare clic su Chimica (SPAAC & CuAAC): Per l'etichettatura specifica del sito, incorporazione di amminoacidi non canonici che trasportano azide (per esempio., L-azidoomoalanina) o i manici alchinici consentono la cicloaddizione azide-alchino promossa da deformazione priva di rame (SPAAC) con fluorofori funzionalizzati DBCO, biotina, o catene PEG in condizioni acquose blande.
- Pinzatura e ciclizzazione: Per bloccare le conformazioni α-elicoidali previste, suturazione di idrocarburi tramite metatesi di chiusura dell'anello (RCM) o la ciclizzazione del ponte lattamico tra i residui Lys e Asp/Glu migliora la stabilità proteolitica e la permeabilità cellulare fissando la conformazione bioattiva.
Traguardi di convalida ortogonale a più livelli
Una delle principali insidie nella scoperta computazionale dei peptidi è lo spostamento dei risultati sintetici grezzi direttamente nei test di legame ad alto rendimento o basati su cellule. Campioni di scarsa purezza, tracciare i prodotti di troncamento, TFA residuo, e gli aggregati colloidali spesso producono attività falsamente positiva.
Per garantire che i colpi in silico diventino affidabili, piste scientifiche verificabili, i programmi di scoperta dovrebbero implementare una roadmap di convalida ortogonale a 4 livelli.
Pietra miliare 1: Massa intatta & Purezza (HR-ESI-MS / RP-HPLC ≥95%)
Pietra miliare 2: Monodispersità & Stato della soluzione (DLS-PdI <0.15 / SEC-MALS) Pietra miliare 3: Controllo di integrità della struttura secondaria (CD UV lontano 190–250 nm) Pietra miliare 4: Legame cinetico diretto (SPR / DIVENTA Sensorgrammi in tempo reale)
Pietra miliare 1: Verifica della massa e della purezza dell'integrità (LC-MS)
- Obiettivo analitico: Confermare che il materiale fisico corrisponda alla precisa composizione atomica della sequenza progettata e soddisfi le soglie di purezza minime.
- Metodologia: Cromatografia liquida-spettrometria di massa ESI-TOF o Orbitrap ad alta risoluzione (LC-MS) funzionante in modalità ioni positivi, abbinato a Ultra-Performance RP-HPLC utilizzando una colonna C18 e a 0.1% Gradiente acqua/acetonitrile TFA.
- Criteri di accettazione: Errore di massa esatto ≤ 5 ppm; purezza cromatografica ≥ 95% mediante integrazione dell'area del picco UV a 214 nm e 280 nm; totale assenza di sequenze di delezione troncate o di gruppi protettivi non scissi. Come dettagliato in il protocollo biofisico di scoperta precoce di farmaci PMC (2020), la rigorosa verifica di massa è la porta d'ingresso non negoziabile per tutte le valutazioni biofisiche a valle.
Pietra miliare 2: Comportamento della soluzione e monodispersità (DLS & SEC-MALS)
- Obiettivo analitico: Verificare che il peptide rimanga monodisperso nel tampone fisiologico e non formi aggregati colloidali non specifici che causano inibizione promiscua o falso legame.
- Metodologia: Diffusione dinamica della luce (DLS) misurazione del raggio idrodinamico (Rₕ) attraverso un gradiente di concentrazione (10 µM a 1 mm), supportato dalla cromatografia ad esclusione dimensionale abbinata alla diffusione della luce multi-angolo (SEC-MALS).
- Criteri di accettazione: Indice di polidispersità (PdI) < 0.15; singolo picco simmetrico su SEC-MALS corrispondente al monomerico calcolato (o dimerico intenzionale) peso molecolare; nessuna crescita delle particelle dipendente dal tempo 24 ore a 25°C.
Avvertimento: Non saltare mai DLS o SEC-MALS prima dei test di legame ottico o basato sulla superficie. Gli aggregati colloidali submicronici possono essere adsorbiti in modo non specifico sulle pareti della micropiastra o sui chip dei sensori, generando segnali di affinità nanomolari artificiali che svaniscono quando testati contro controlli monodispersi.
Pietra miliare 3: Struttura secondaria e controllo di sanità pieghevole (Spettroscopia CD)
- Obiettivo analitico: Determinare se il peptide sintetizzato adotta la struttura secondaria prevista da AlphaFold, Rosetta, o modelli generativi.
- Metodologia: Dicroismo circolare nell'UV lontano (CD) spettroscopia registrata da 190 nm a 250 nm in cuvette di quarzo (1 lunghezza del percorso mm) in varie condizioni tampone, temperature, e ambienti che imitano la membrana (per esempio., Micelle di TFE o SDS).
- Criteri di accettazione: Segni spettrali distinti corrispondenti alle pieghe previste:
- α-elica: Doppi minimi a 208 nm e 222 nm, con un picco positivo vicino 190 nm.
- Foglio β: Singolo minimo negativo a 218 nm e un picco positivo vicino 195 nm.
- Bobina casuale: Minimo negativo vicino 198 nm (indicando conformazione non strutturata in soluzione).
Pietra miliare 4: Legame cinetico diretto e analisi funzionale (SPR / DIVENTARE)
- Obiettivo analitico: Quantificare la cinetica di legame in tempo reale (tasso di associazione kₒₙ, tasso di dissociazione kₒff, e costante di dissociazione di equilibrio K D) contro la proteina bersaglio.
- Metodologia: Risonanza plasmonica di superficie (SPR) o interferometria del biostrato (DIVENTARE). Le proteine bersaglio vengono immobilizzate tramite accoppiamento amminico o biotinilazione sito-specifica su chip sensore. I peptidi vengono iniettati in una serie multi-concentrazione che va da 0,1× K D a 10 × K D.
- Criteri di accettazione: Dipendente dalla concentrazione, sensorigrammi saturabili che si adattano a 1:1 Modello di rilegatura di Langmuir; sottrazione del canale di riferimento a doppio canale che conferma zero legami non specifici con la matrice; accordo tra K cinetica D (kₒff / kₒₙ) e calcoli di affinità dello stato stazionario.
Partnership per sintesi complesse e scalabilità dei processi
La traduzione delle previsioni del machine learning in sequenze pronte per il laboratorio richiede uno stretto coordinamento tra la biologia computazionale e le competenze specializzate in chimica dei peptidi. Quando la capacità interna del laboratorio umido o le apparecchiature di sintesi limitano la gestione di sequenze difficili, la collaborazione con una piattaforma di sintesi della ricerca dedicata colma il divario di esecuzione.
A Modifiche MOL, siamo specializzati nel colmare il divario tra calcolo e laboratorio per la biotecnologia avanzata, farmaceutico, e gruppi di ricerca accademici:
- Triage in sequenza personalizzata & SPSS: Esecuzione esperta di complessi, idrofobico, o sequenze soggette ad aggregazione che utilizzano tecnologie specializzate di sintesi in fase solida e di flusso adattate a progetti difficili. Negli studi di riferimento con alto GRAVY (>+0.4) disegni computazionali, la nostra strategia proattiva del dipeptide pseudoprolina ha migliorato la resa media della sintesi grezza <15% oltre 82%.
- Classe 100 Lavorazione in camera bianca ultrasterile: Per cellulare, organoide, o applicazioni in vivo, i peptidi vengono sintetizzati ed elaborati all'interno della Classe 100 ambienti sterili, offrendo rigorosi controlli di sterilità e un trattamento garantito a basso contenuto di endotossine (< 0.01 UE/mg).
- Ampio portafoglio di modifiche: Accesso a oltre 300 modifiche funzionali, compresi gli amminoacidi non canonici, dipeptidi pseudoprolinici, maniglie dei clic specifiche del sito, etichette fluorescenti, e l'etichettatura degli isotopi stabili.
- Controllo di qualità analitico pronto per l'audit: Ogni peptide consegnato include una soluzione completa, documentazione specifica per lotto: funzionalità cromatogrammi HPLC batch-specifici e spettri di massa per garantire l’identità, elevata purezza (≥95%), e completa coerenza tra lotti.
Lista di controllo attuabile per la traduzione dei peptidi in silico
Standardizzare la transizione delle previsioni del machine learning in risorse di laboratorio testabili, utilizzare la seguente checklist operativa:
- Audit della sequenza pre-sintesi
- Calcola il punteggio GRAVY, punto isoelettrico, e fattore di aggregazione (DI).
- Segnala Asp-Pro, Asn-Gly, e motivi Met/Trp non protetti per la mitigazione chimica.
- Verificare la lunghezza complessiva e la carica netta nelle condizioni di pH del test.
- Selezione della strategia sintetica
- Selezionare resine PEG a bassa sostituzione (0.15–0,25 mmol/g) per sequenze > 20 residui.
- Pre-inserire dipeptidi pseudoprolina nei siti nativi Xaa-Ser/Thr all'interno delle regioni idrofobiche.
- Pianificare cocktail scavenger per sequenze contenenti residui sensibili all'ossidazione.
- Convalida di laboratorio a più livelli
- Confermare la massa intatta mediante ESI-MS ad alta risoluzione (errore ≤ 5 ppm) e purezza (≥ 95% mediante HPLC).
- Valutare la monodispersità mediante DLS (PdI < 0.15) prima di iniziare studi vincolanti.
- Convalidare la piega prevista mediante spettroscopia CD Far-UV.
- Eseguire il legame cinetico SPR/BLI con sottrazione di riferimento a doppio canale.