空間生物学では、バルク法や単一細胞法では得られないものは何でしょうか。?
合成ポリペプチドの卸売 溶液ペプチド 位置はバルクシーケンスによって破壊される変数です, そしてそれはペプチドプローブが生き残るために必要な変数です. 空間トランスクリプトミクスは、無傷の組織内の RNA の物理座標とともに遺伝子発現を測定します, したがって、どの細胞または領域が転写物を発現するかを解決します, 彼らは隣の人とどのくらい近い距離に座っているのか, レイヤーなどのパターン, ニッチと境界, 一方、バルク RNA-seq は組織全体の平均値であり、解離単一細胞法は地位を失います。 (空間トランスクリプトミクスのレビュー, 2023). 理念を確立した創業法: 固有の位置バーコードを保持するアレイ逆転写プライマー上に配置された組織切片は、定量的発現と mRNA の二次元分布を返します。, マウスの脳とヒトの乳がんで最初に示された (オリジナルの空間トランスクリプトミクス法, 2016).
メソッドは、異なる故障モードを持つ 2 つのクラスに分割されます。. イメージングベースのプラットフォームは、高度に多重化された単一分子 FISH を使用して、シーケンスを行わずに標的遺伝子を解読します, 一方、シーケンスベースのプラットフォームは、アレイ上の空間バーコードと次世代シーケンスを使用して位置を復元します。 (空間トランスクリプトミクスの 2 つのテクノロジー クラス, 2023). どちらのクラスもこの分野の中心的なトレードオフから逃れることはできません. に遡る文献の精選されたレビュー 1987 解決策間の緊張関係を文書化する, 単一の最適なプラットフォームではなく、スループットと感度 (空間手法の分野独自の分類, 2022).
数字がトレードオフを具体化する. 6 種類のがんの一致する FFPE ヒト腫瘍切片で 5 つの商用プラットフォームを実行した独立ベンチマーク, Visium v1 および v2 の使用 55 μmスポット, 一方、Visium HD は連続した 2 × 2 μm バーコード グリッド 6.5 × 6.5 mm キャプチャエリア, おおよそ譲る 11 ネイティブ解像度で 100 万個のビン, と 8 μmと 16 通常、代わりにμm凝集体が使用されます (適合組織プラットフォームのベンチマーク, 2026). 同じベンチマークでイメージング パネルを測定しました。 377 Xenium Multi-Tissue の遺伝子, 5,000 Xenium Prime の遺伝子, そして 1,000 CosMx Universal Cell Characterization パネル用の遺伝子, Xenium を使用すると、最大で連続領域をスキャンできます。 1.1 × 2.4 ディスクリートに対する cm 0.5 × 0.5 CosMx の mm 視野 (同じベンチマークの測定パネルサイズ, 2026). バイオマーカーの発見に, その幾何学は、まれな浸潤マージン集団がそもそも解決可能かどうかを決定する, または平均化されるかどうか 55 隣の実質に沿ったμmスポット.
空間生物学によるペプチド設計でターゲットの優先順位が変わるのはなぜですか?
空間データにより発現レベルと発現位置が分離されるため、優先順位が変更されます。, プローブは両方を満たす必要があります. 空間分析に関する最初に公開されたルールは、その手法に着手する前に空間情報が不可欠であることを確認することです。, これは、ペプチドプログラムが候補ターゲットに適用する必要があるのと同じテストです (公開されている空間分析の 10 のルール, 2026). ターゲットの価値がその位置に依存しない場合, a bulk measurement answers the question more cheaply.
Use an analysis that respects the experimental unit, patient or animal replication, spatial dependence and multiple testing. These are important design checks; the cited sources do not establish that statistics is where most tissue-based programs fail.
This is the practical sense in which spatial biology for peptide design changes target prioritization: the ranking criterion shifts from abundance to accessible abundance in a defined compartment. A transcript enriched in a region the probe cannot reach ranks below a moderately expressed target on a surface the assay can sample. The evidence for that reframing is structural rather than statistical, and it comes from the discordance between RNA and protein measured in the same sections, 次のセクションで取り上げます.
局所発現と細胞状態マップはどのようにしてペプチドプローブの設計基準となるのか?
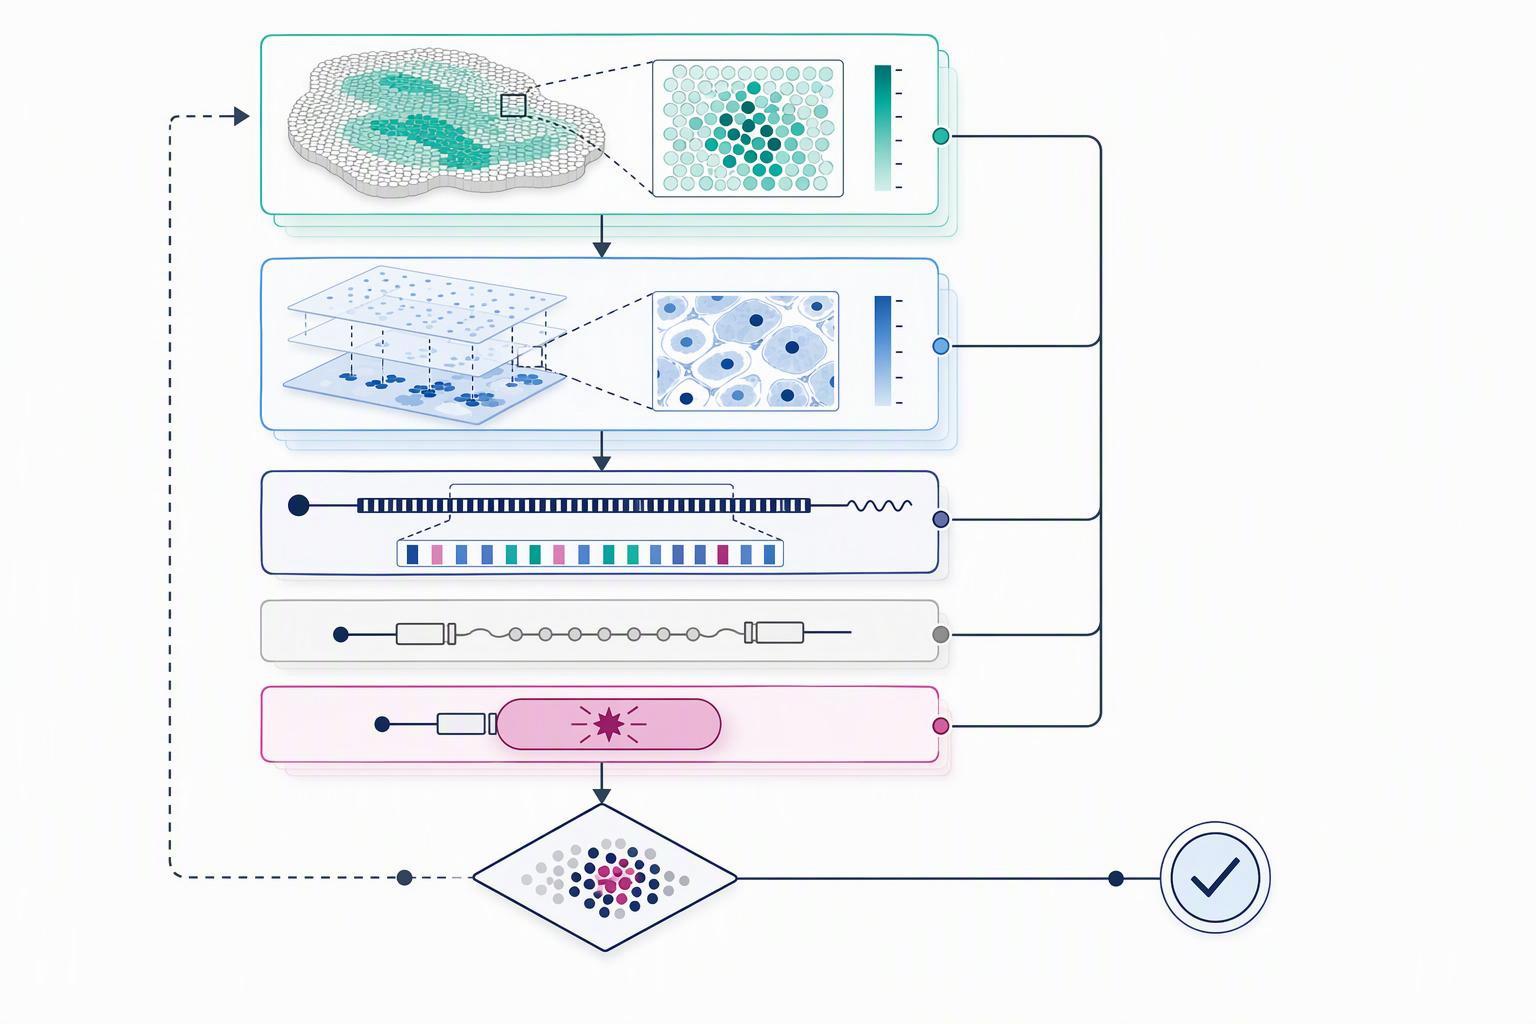
プローブには 3 つの部分があります, そして空間データは 3 つすべてを制約します. 一次文献ではプローブをターゲティング部分として定義しています, リンカーとレポーターグループ, そして、プロテアーゼを標的とするプローブには、標的プロテアーゼに選択的なペプチド認識配列とレポーターが必要であると述べています。 (ペプチドプローブがどのように構築され選択されるか, 2025). ローカリゼーション データは最初の部分に直接フィードされます: 認識配列は、プローブがサンプリングするコンパートメントに存在するターゲットと一致する必要があります。.
同じソースが、空間マップによって実用化されるデザイン上の特徴を引き出しています。. 1 つの酵素が多くのプローブ分子を処理するため、基質ベースのプローブはシグナルを増幅します。, 一方、阻害剤ベースのプローブは共有結合および化学量論的に結合し、触媒機能を直接読み取ることができます。 (ペプチドプローブがどのように構築され選択されるか, 2025). 標的酵素を限定して示す細胞状態マップ カスタムペプチドファクトリー 小さな領域が増幅アーキテクチャを主張している, 化学量論的な読み出しは、その領域に含まれる標的分子の数によって制限されるためです。. 記載されている生体内要件も同様に具体的です: 高い標的選択性, 同様の特異性を持つオフターゲット酵素による切断に対する耐性を意味します。, 数分以内にシグナルを発する高速活性化反応速度, 循環の安定性と良好な薬物動態 (ペプチドプローブがどのように構築され選択されるか, 2025).
ペプチド化学自体は画像グレードの精度に調整されています, 設計されたプローブが何を達成できるかについての期待を設定します. 合理的に再設計されたE/Kコイルドコイルペアが到達 4 Peptide-PAINT における nm 位置特定精度, に対して 3.6 DNA-PAINTのnm, イメージャペプチドを K18 に短縮すると、精度が 8.5 nm, そしてペアは幅広い親和性の範囲に及びます: E3/K3で 21 に近い解離定数を持つアミノ酸 20 nM, E22/K19付近 81 nM, E22/K18付近 1.7 μM (ペプチドペアがイメージング用にどのように調整されるか, 2020). 結合反応速度と親和性は設計変数です, ペプチドの固定されていない特性. 同じロジックが組織プローブにも適用されます: シーケンス, リンカーとレポーターはそれぞれ検出閾値を移動します.
ラベリング戦略により、空間読み取り値で表示できる内容がどのように変化するか?
ラベルにより、読み出し結果がどの分子層を報告するかが決まります。, そして層は同意しない. 適合組織ベンチマークで, 空間的な RNA とタンパク質の相関関係をほぼ平均化 0.1 すべての遺伝子とサンプルにわたって, おおよそに対して 0.7 7 種類の癌にわたる CPTAC の一致するバルク腫瘍サンプル (適合組織プラットフォームのベンチマーク, 2026). この研究の空間プロテオミクス部門では、同じセクションに 35 種類のタンパク質の免疫腫瘍学パネルを使用しました。. したがって、転写データのみから設計されたプローブは、その場でのタンパク質存在量の予測が不十分な測定に対して設計されています。, バルク相関関係が安心できるように見える場合でも.
不一致は一様ではない, パネル設計にとって重要なこと. 同じ研究では、1 つの不一致率ではなく、遺伝子全体にわたる 3 つの異なる RNA とタンパク質の一致パターンが特定されました。 (適合組織プラットフォームのベンチマーク, 2026). 一部のターゲットはレイヤー間を追跡しますが、一部のターゲットは追跡しません, そのため、トランスクリプト信号のみに対してプローブを検証するプログラムは、不一致なクラスに対して間違った層をテストしていることになります。. 実際的な対応策は、プローブが遭遇する層を報告するラベルを選択することです。: 表面タンパク質へのアクセス性を示す抗体ベースの読み取り, 発現マッピングのトランスクリプト読み出し, 多重化されたタンパク質ターゲットが必要な場合の質量タグの読み取り.
ラベルフリーのアプローチでは抗体の問題は解消されますが、独自の制約が課せられます。. 質量分析イメージングは、ラベルや抗体を使用せずに実験ごとに数千の分子を画像化します, 市販の MALDI-MSI は、一部の機器で 5 ~ 10 µm の横方向分解能に達します。, 新しい光学システムを使用した大気圧MALDIで、 1.4 レーザー後イオン化到達によるμmおよび透過モードMALDI 600 脳組織内のnm (ラベルフリー質量分析イメージング, 2024). この解決には、プローブの設計者が計画しなければならないコストがかかります: MALDI MSIで, 高空間分解能でのタンパク質イメージングでは、ピクセルサイズが小さくなるにつれてアブレーションされ検出可能な分析物が失われます, マトリックスの結晶サイズにより、達成可能な解像度が大幅に制限される可能性があります (MALDI の空間解像度を制限するもの, 2026). より高い解像度とより低い感度を同時に実現.
空間データからアッセイ形式とコントロールをどのように選択すべきか?
この形式は、細胞密度とコンパートメントのサイズに関する空間データの内容に基づいています。, そしてコントロールはフォーマットに従います. 光学的混雑のため、イメージングベースのパネルは数百から数千遺伝子の範囲にとどまる, ハイブリダイゼーションラウンドの増加に伴う結合エラーのリスクの増加, 撮影時間が長く、撮影範囲が狭い, そのため、完全なトランスクリプトームをカバーすることを前提としたフォーマットは、現在どちらの現場プラットフォームからも利用できません。 (空間トランスクリプトミクスの 2 つのテクノロジー クラス, 2023).
ローカリゼーションを解釈する前にセグメンテーションとセル割り当ての品質を評価する. 引用されたデータセットの QC 指標はそのプラットフォームを説明します, パネルと処理バージョン; 彼らは、セグメンテーションが研究室全体で最も頻繁に省略される管理であることを確立していません。.
品質管理と正規化はフォーマットの決定に含まれます, それ以降ではない. 遺伝子数が極端に少ない、またはミトコンドリア画分が異常に多い、低品質のスポットまたは細胞は、除去するかフラグを付ける必要があります。, 各スポットを単一の細胞と同等に扱うべきではありません。, スポットベースのデータのライブラリサイズの正規化は、スポットに複数の細胞が含まれる場合に生物学を混乱させるためです, ペプチドサプリメント これが、SpaNorm などの空間認識手法が開発された理由です。 (空間データ処理のコミュニティ ワークフロー リファレンス, 現在のリリース). あ 55 μm スポットには複数の細胞が含まれています, したがって、ペプチドアッセイにおけるスポットごとの強度閾値はその混合物を継承します。.
組織ベースのペプチド結果のアーティファクトから真のターゲットの位置をどのように判断するか?
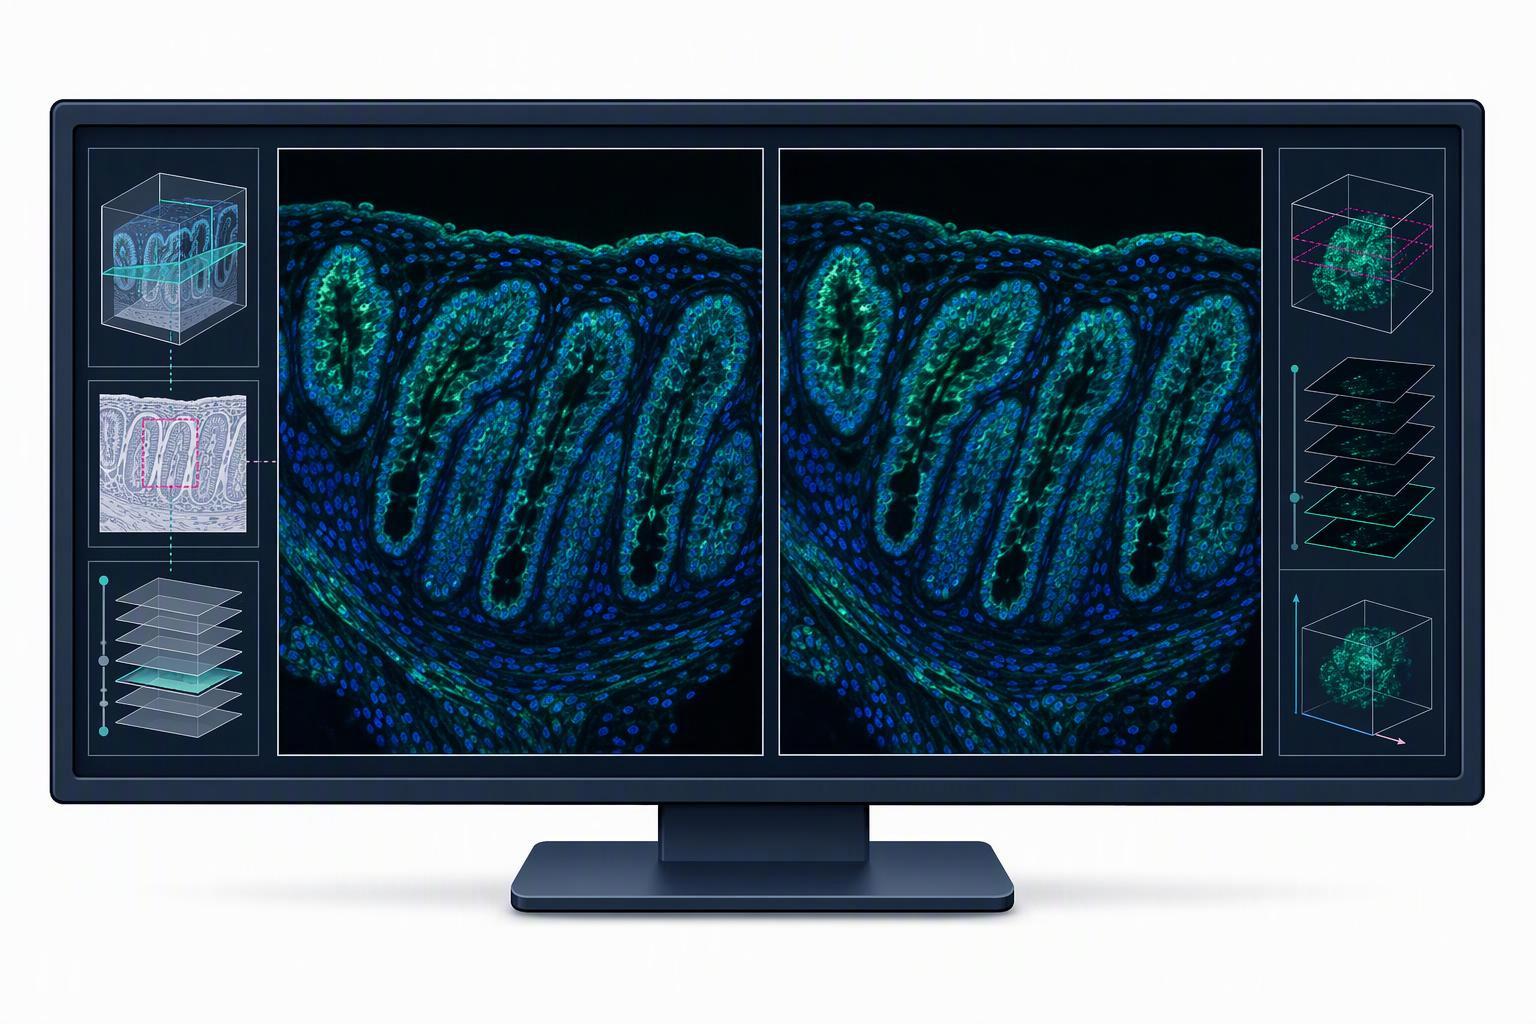
アーティファクトの検出はプラットフォーム独自のジオメトリから始まります, サンプリング領域だけで答えが変わる可能性があるため. ベンチマークでは, Xenium でスキャンされた領域全体からの細胞組成推定値は、6 つのサンプルのうち 2 つで CosMx 重複領域の推定値と異なっていました。, 乳房と結腸直腸, 空間的に一致する地域に限定すると、2 つのプラットフォームは大まかに合意したにもかかわらず (適合組織プラットフォームのベンチマーク, 2026). あるスキャン領域では濃縮されているように見え、他のスキャン領域では濃縮されていないように見えるターゲットは、そうでないことが証明されるまではサンプリングアーチファクトです. ペプチド卸売メーカー
このベンチマークは、プラットフォームの違いが必ずしも生物学的なものではないことも示しています. ゼニウムは一貫して検出されました 5% に 30% CosMxよりも多くのセル, 著者はセグメンテーションの違いが原因であると考えています: Xenium は DAPI 染色を使用して核を特定し、計算によって境界を拡張します, 一方、CosMx には核染色と膜染色の両方が組み込まれています。 (適合組織プラットフォームのベンチマーク, 2026). そのサイズのセル数の差により、セルごとの正規化が変更されます, したがって、細胞数に基づいて構築された位置特定の主張には、それに沿って記載されたセグメンテーション方法が必要です.
さらに 2 つのチェックで信号とアーティファクトを分離します. 初め, ベンチマークの最も直接的に比較可能なデータセットは、一緒に処理されたシリアル セクションから生成されました, 一方、Xenium 5,000 遺伝子とセグメント化されたデータセットは、更新された試薬を使用して数か月後に生成されたため、残りのコホートと直接比較することはできません。, したがって、クロスプラットフォームの比較にはその点に注意する必要があります (適合組織プラットフォームのベンチマーク, 2026). 2番, アライメント自体が誤差の原因となる: ベンチマークは、画像編集ソフトウェアで定義された回転角度とランドマークのシフトによって Xenium と CosMx の座標を調整しました, 一方、オープン データ フレームワークでは、Xenium と Visium の乳がんデータで実証されたランドマークベースの位置合わせと座標変換が提供されています。 (空間データセットを共有するためのオープン フレームワーク, 2024). 手動調整手順はアーティファクトのソースとして文書化されています, 中立的な前処理の選択ではない.
空間情報に基づいたペプチド研究は次はどこへ向かうのか?
データ層は、プロジェクトごとにオーダーメイドで行うのではなく、再利用可能なインフラストラクチャになりつつあります, そしてそれは探査プログラムの経済性を変える. フィールドのオープン フレームワークは、空間データを 5 つのプリミティブとして表現します。, 画像, ラベル, ポイント, 図形とテーブル, 各データセットに適用された座標変換と位置合わせステップを追跡します, そして、その目的を、マルチモーダルな空間データと共通の座標フレームワークの公正な統合であると述べています。 (空間データセットを共有するためのオープン フレームワーク, 2024). 探査機を設計する前に公開空間データセットをクエリできるチームは、すでに位置証拠を持っているターゲットに合成予算を費やします.
市場数値はスコープを付けて読む必要があります, 彼らは構造的に同意しないからです. 空間生物学市場は、2016 年に約 11 億 4,000 万ドルと推定されています。 2026 までに約24億6,000万ドルと予測 2031, について 17% 年間成長率, 多重免疫蛍光を含む範囲で, デジタル空間プロファイリング, マルチプレックス FISH およびイメージングマスサイトメトリー装置, 試薬とサービス (空間生物学市場予測, 2026). 別の範囲のレポートでは、空間オミクス市場は 7 億 1,100 万米ドルと推定されています。 2024, 推定9億630万ドル 2026 および16億9,650万米ドル 2030 で 16.3% CAGR, 消耗品付き 56.2% の 2024 収益と北米 57.4% (空間オミクス市場データ, 2025). 2 つは同じ測定値ではありません, それらを 1 つの図に混ぜ合わせると、両方を誤って表現することになります. 彼らが同意しているのは、方向性と消耗品の多い組み合わせです.
これらすべてに対する正直な限界は、組織内でのペプチドプローブの検出閾値が依然として公的文献で十分に規定されていないことです。. ここには fmol または amol での検出限界の数値を示す情報源はありません。, または受容体密度の閾値, 組織アッセイにおけるペプチドプローブ用, MALDI レビューでは、下限値を定量化することなく、分解能と分析物のトレードオフについて述べています。 (MALDI の空間解像度を制限するもの, 2026). ピクセルサイズが大きくなると感度が低下する, 浸透とバックグラウンドはラベルの化学的性質に依存します, しかし、チームはまだ公開された数値に基づいて設計することができません. このギャップは、空間データセットが内部的に埋めるのに役立つ最も有益なものです。, シーケンスに取り組む前にチーム自身の組織の閾値を測定することによって.
よくある質問
空間トランスクリプトミクスはタンパク質レベルの標的検証に代わることができるか?
いいえ. RNA の存在量は表面タンパク質の測定値ではありません, そのため、転写マップではターゲットの存在を確認できません, 折りたたまれており、細胞表面に到達可能. ギャップは問題になるほど大きい: 適合組織プラットフォームのベンチマークで, RNA とタンパク質の空間シグナルはおよそ 0.1, 一方、バルク腫瘍材料中の同じ分析物は約 0.7 (適合組織プラットフォームのベンチマーク, 2026). 転写結果をタンパク質アッセイを実行する理由として扱う, その代わりとしてではなく. ペプチドサプリメント
HPLC 純度が高いということは、ペプチドプローブが組織特異的であることを意味しますか??
HPLC エリア純度は検出器です- および方法に依存するピーク面積比, 必ずしもターゲットの質量分率ではない. 結合選択性は確立されません. テストプローブのアイデンティティ, ターゲット認識, 適切なコントロールを使用した組織へのアクセス性と関連するオフターゲット結合.
組織ベースのペプチド研究には生物学的複製が何回必要ですか?
患者での反復回数をカウントします, 動物またはサンプルレベル, スポットレベルや細胞レベルでは決してありません. 空間的に自己相関のあるスポットは独立した観測ではありません, そしてそれらをそのように扱うことは重要性を増大させます, これは、空間解析の公開ルールが直接呼び出す擬似複製問題です。 (公開されている空間分析の 10 のルール, 2026). 数値自体は効果の大きさと組織の不均一性に依存します, 実際にサンプリングしている生物学的単位に対して電力を供給します.
Visium と Xenium データセットを直接比較できますか?
データの生成方法を尊重して比較する場合のみ. 同じ実行で一緒に処理された連続セクションは比較可能です; データセットは数か月間隔で作成されました, 異なる試薬バージョンまたは更新されたパネルを使用, ではありません, 測定パネルと化学反応が異なるため. ベンチマーク自体の警告にはこの制限があります, とそのパネルサイズは広がりを示しています: 377 Xenium Multi-Tissue の遺伝子, 5,000 ゼニアムプライムと 1,000 CosMx Universal Cell Characterization パネル用 (適合組織プラットフォームのベンチマーク, 2026). マッチプラットフォーム, 2 つのデータセットを 1 つの軸に配置する前のパネルと処理バッチ.
空間RNAとタンパク質が一致しない場合はどうすればよいですか?
意見の不一致を異常ではなく予想通りに扱う, タンパク質レベルで解決します. 不一致は、組織内のこれら 2 つの層の基本的な動作です。, 1 つのデータセットが壊れているという兆候ではない, したがって、その後の決定は、どの測定値があなたの質問に答えるかということになります. プローブが特定のコンパートメント内のターゲットに到達できるかどうかが問題の場合, タンパク質の読み取り値がそれを決定します, そしてトランスクリプトマップはその答えの周りの位置的なコンテキストを提供します.
結論
空間データは、存在量だけが基準ではなくなる時点でペプチド設計の決定を変える. 適合組織ベンチマークはおよそ 0.1 大まかな RNA とタンパク質の空間相関 0.7 大量のデータは、トランスクリプトのランキングのみから設計されたプローブが間違ったレイヤーに対して設計されているという最も明らかな証拠です。 (適合組織プラットフォームのベンチマーク, 2026). 組織結果を防御可能にするコントロールは同様に特異的です: カウントはサンプルレベルで複製されます, セグメンテーション方法を述べる, サンプリング領域を答えを動かすことができる変数として扱います.
この作業を開始するチームの次のステップは、シーケンスをコミットする前にメソッドを読むことです。. 公開されている空間分析に関する 10 のルールは短いものです。, プラットフォームの選択をカバーする実用的なチェックリスト, ワークフロー構造, セグメンテーション ツールと技術的な限界を認識する必要性, 最初のセクションがカットされるまでに 1 時間の価値があります (公開されている空間分析の 10 のルール, 2026). 適合組織ベンチマークと合わせて読んでください。, 何を認識すべきかを決定する前に、プローブがどのコンパートメントに到達する必要があるかを決定します.