Was Peptiddaten-Workflows für die KI-Wirkstoffforschung tatsächlich erfordern
Peptiddaten-Workflows für die KI-Wirkstoffforschung dienen der Aufzeichnung, analytisch, und Governance-Praktiken, die einen Peptiddatensatz durch ein Vorhersagemodell maschinell nutzbar machen. Sie decken fünf Bereiche ab: Sequenz- und Änderungsaufzeichnungen, Assay-Kontext, Verunreinigungsdaten, Chargenhistorie, und standardisierte Analyseergebnisse. Was sie von allgemeinen Ratschlägen zur Datenbereitschaft unterscheidet, besteht darin, dass jede Anforderung auf der Ebene eines einzelnen Datensatzfelds landet, und jeder muss sowohl eine Vertraulichkeitsprüfung als auch ein dokumentiertes Validierungsprotokoll bestehen.
Die Rekordmarke ist der Teil, den die meisten Teams unterschätzen. Die Referenzbehandlung der Peptidstrukturnotation geht davon aus, dass Pipelines für maschinelles Lernen am besten mit einer verlustfreien chemischen Darstellung als primärem Datensatz funktionieren, mit modellspezifischen Kodierungen, die daraus abgeleitet und nicht als Quelle der Wahrheit gespeichert werden (Annotation von Peptidstrukturen mithilfe von SMILES und anderen chemischen Codes, 2017). In diesem Ansatz, InChIKey fungiert als Identitäts- und Deduplizierungsschlüssel, während Zyklisierung und Vernetzung als explizite Verbindungsobjekte geschrieben werden müssen und nicht implizit bleiben müssen.
Die Regulierungsbehörden bewegen sich in die gleiche Richtung. Der Januar der FDA 2025 Der Leitlinienentwurf zu KI bei regulatorischen Entscheidungen führt eine risikobasierte Glaubwürdigkeitsbewertung ein, die an einen definierten Nutzungskontext gebunden ist (Leitlinienentwurf der FDA, Inhalt aktuell 2025-01-06). Es handelt sich um einen Entwurf, nicht zur Umsetzung, Aber es signalisiert, dass KI-fähige Peptiddatensätze eher nach Rückverfolgbarkeit als nach Volumen beurteilt werden.
Schlüssel zum Mitnehmen: Drei Dinge unterscheiden diese Arbeitsabläufe von der gewöhnlichen Datenbereinigung: Anforderungen an Datensätze auf Feldebene, Vertraulichkeitsmechanismen, die es Partnern ermöglichen, Daten auszutauschen, ohne einen Lead preiszugeben, und ein betriebliches Validierungsprotokoll anstelle eines festgelegten Prinzips.
Zwei Missverständnisse sorgen für die meiste Verwirrung. „Saubere Daten“ bedeuten nicht „kuratierte Daten“, Eine aufgeräumte Tabelle kann für ein Modell immer noch unbrauchbar sein. Und eine einzelne Reinheitszahl beschreibt kein Peptid; Verunreinigungs- und Chargenverlaufsdaten enthalten die Informationen, aus denen ein Modell tatsächlich lernen kann. Dieser Abschnitt stützt sich auf von Experten begutachtete Literatur zur Strukturnotation und aktuelle regulatorische Leitlinien, ohne Lieferantenquellen.
Warum Peptiddaten-Workflows für die KI-Wirkstoffforschung jetzt wichtig sind
Peptiddaten-Workflows für die KI-Wirkstoffforschung sind wichtig, weil das Geld jetzt vor den Daten fließt. Im 2026 KI-Deal-Tracker, veröffentlicht von VLS Research, Die offengelegten Vorauszahlungen liegen bei 30 bis 50 Millionen US-Dollar, während die Gesamtwerte über 1 Milliarde US-Dollar liegen, Etwa 2–3 % des Gesamtwerts werden in bar ausgezahlt (VLS-Forschung, AI Drug Discovery Deal Tracker 2026, abgerufen 2026-07-03). Isomorphic Labs–Eli Lilly weist im Voraus etwa 45 Millionen US-Dollar aus, gegenüber über 1,7 Milliarden US-Dollar an Meilensteinen; Noetik–GSK weist 50 Millionen US-Dollar im Voraus für eine fünfjährige Lizenzstruktur aus. Beachten Sie die Quelle: ein Analysten-Tracker, mit einem Anbieterinteresse an der KI-Deal-Erzählung.
Die Krankenakte ist das Gegengewicht. Um 90% der Moleküle, die in die Klinik gelangen, erhalten nie eine Zulassung, und 50–60 % der Phase-II-Misserfolge sind auf mangelnde Wirksamkeit zurückzuführen, Zahlen, die sich in zwei Jahrzehnten kaum bewegt haben (Mao Z & Yan L, Grenzen in der Pharmakologie, abgerufen 2026-07-03). Das gleiche 2024 systematische Überprüfung von 20 KI-gesteuerte Programme von 2018 Zu 2023 fanden heraus, dass die KI-gestützte Lead-Optimierung die Auswahlzeit für Kandidaten im Durchschnitt um 30–50 % verkürzte, während die Fluktuation in Phase I/II mit den Branchen-Benchmarks vergleichbar blieb.
Diese Lücke ist der Punkt. Partner können jetzt ein Model anmelden, Ein Modell kann jedoch nicht aus Aufzeichnungen lernen, in denen das Peptid nie erfasst wurde.
Dies betrifft R&D führt, analytische Chemie, Daten und IT, und die Allianzmanager, die nach der Unterschrift Sorgfaltsfragen erben.
Die fünf Datensäulen KI-fähiger Peptiddatensätze
KI-fähige Peptiddatensätze basieren auf fünf Säulen auf Datensatzebene, und zusammen bilden sie die Bereitschaftscheckliste, anhand derer ein Team vor der Unterzeichnung einer Partnerschaftsvereinbarung punkten kann. Jede der Säulen unten ist auf die gleiche Weise geschrieben: warum es wichtig ist, wie man es umsetzt, und wie ein Scheitern aussieht, wenn es fehlt. Die Reihenfolge ist bewusst. Identität steht an erster Stelle, weil jedes nachgelagerte Feld, vom Assay-Kontext bis zum Verunreinigungsprofil, erbt die Fehler eines mehrdeutigen Strukturdatensatzes. Ein Modell, das auf einer falsch spezifizierten Sequenz trainiert wurde, scheitert nicht lautstark; Es lernt das falsche Molekül und meldet zuverlässige Vorhersagen darüber.
Bewerten Sie jede Säule ehrlich. Ein Team, das jedes Peptid aus seinen eigenen Aufzeichnungen rekonstruieren kann, Fügen Sie jedem Ergebnis Testbedingungen hinzu, und verfolgen Sie jede Charge anhand eines Analysezertifikats, um die Daten an einen Partner weitergeben zu können. Einem Team, das dies nicht kann, wird die Zusammenarbeit nicht verwehrt, Es ist jedoch davon auszugehen, dass die ersten Monate der Zusammenarbeit eher für die Datenkorrektur als für die Modellschulung aufgewendet werden.
Pillen 1: Eindeutige Sequenz- und Änderungsaufzeichnungen
Peptidsequenz- und Modifikationsaufzeichnungen sind wichtig, weil ein Modell nicht von einem Peptid lernen kann, das es nicht rekonstruieren kann, und Identitätsfehler breiten sich stillschweigend durch jede nachgelagerte Vorhersage aus. Der Fix ist eine verlustfreie chemische Darstellung als primärer Datensatz, mit modellspezifischen Kodierungen, die daraus abgeleitet und nicht als Quelle der Wahrheit gespeichert werden.
Die Implementierung folgt einer kleinen Reihe von Konventionen. HELM kümmert sich um polymerbewusste Strukturen, einschließlich Verzweigungen und nichtnatürlicher Monomere, während SMILES Diagrammmodelle auf Atomebene bereitstellt. InChI und InChIKey fungieren systemübergreifend als Deduplizierungs- und Identitätsschlüssel. Zyklisierung und Vernetzung gehören zu expliziten Verbindungsobjekten, niemals als implizite Annahme, dass „zyklisiert“ überall dasselbe bedeutet. Den Rest deckt die Referenzbehandlung der Peptidstrukturnotation ab: Mehrbuchstabencodes für Nicht-Protein- oder nicht-natürliche Rückstände, Anmerkung in Kleinbuchstaben für D-Aminosäuren, und Anmerkung zur Änderung auf Restebene im MAP-Format (Zeitschrift für Chemieinformatik / PMC).
Der Ausfallmodus ist leise und teuer. Ein Programm erfasst eine Lactambrücke und ein Disulfid als „zyklisiert“ im selben Feld, Daher behandelt das Modell zwei chemisch unterschiedliche Gerüste als eins. Jede auf dieser Spalte basierende Vorhersage ist kontaminiert, und nichts in der Pipeline weist darauf hin.
Ein modellverwendbarer Datensatz für ein modifiziertes makrozyklisches Peptid trägt den unten aufgeführten Feldsatz. MOL Changes unterstützt diesen strukturorientierten Ansatz bei seiner Peptiddatenarbeit, und das Beispiel ist mit jedem konformen Aufzeichnungssystem reproduzierbar.
|
Feld |
Modellverwendbarer Datensatz |
Typischer Freitextdatensatz |
|---|---|---|
|
Primäre Vertretung |
HELM-String mit expliziten Verbindungsobjekten |
In ein Notizenfeld eingefügte Sequenz |
|
Codierung auf Atomebene |
SMILES abgeleitet vom HELM-Datensatz |
Abwesend |
|
Peptidsynthese Identitätsschlüssel |
InChIKey für die Deduplizierung |
Abwesend |
|
Nicht natürlich Synthetische Peptide Rückstände |
Mehrbuchstabige Codes, in einer Monomertabelle definiert |
Näherungen aus einem Buchstaben |
|
Stereochemie |
Anmerkung zu D-Aminosäuren in Kleinbuchstaben |
Nicht aufgezeichnet |
|
Änderungen |
MAP-Anmerkung auf Rückstandsebene |
Freitextnotiz, z.B. „zyklisiert“ |
|
Cyclisierungstyp |
Explizites Brückenobjekt mit Positionen |
Mehrdeutig |
|
Dienstleistungen Vernetzungen |
Explizites Verbindungsobjekt |
Fehlt oder wird angedeutet |
Pillen 2: Assay-Kontext, der mit dem Ergebnis mitreist
Eine Bindungsaffinität ohne ihre Testbedingungen ist kein Trainingsetikett, es ist eine Zahl. Der Assay-Kontext muss mit dem Ergebnis wandern: Assay-Typ, Zielkonstrukt und Spezies, Ausleseformat, und ob der Wert gemessen oder vorhergesagt wurde.
Die Unterscheidung zwischen gemessen und vorhergesagt ist der Punkt, an dem die meisten Datensätze stillschweigend brechen. A 2025 Eine systematische Überprüfung der Epitop-Prädiktoren ergab dies nur 174 von 777 (22%) Es wurde bestätigt, dass rechnerisch vorhergesagte HLA-bindende Peptide in einer SARS-CoV-2-Studie in vitro stabil binden (npj-Impfstoffe, 2025-08-30). Diese Zahl bezieht sich auf eine einzelne Studie, keine allgemeine Genauigkeitsrate für KI in der Immunologie, Aber es zeigt, warum ein vorhergesagter Wert und ein gemessener Wert nicht in einer gemeinsamen Spalte liegen können, ohne dass eine Markierung sie trennt.
⚠️ Warnung: SPR bündeln, Fluoreszenzpolarisation und zellbasierte Werte in einer Affinitätssäule trainieren das Modell anhand des Assays und nicht anhand der Chemie. Das Modell lernt, welches Labor die Nummer generiert hat, nicht, welches Peptid bindet.
Pillen 3: Verunreinigungsprofile, Keine einzige Reinheitszahl
Daten zu Peptidverunreinigungen und Chargenhistorie gehören als Profil in die Aufzeichnung, kein Schlagzeilenprozentsatz. Zwei Lose gemeldet bei 98% pure kann sich in einem Test unterschiedlich verhalten, und das Modell benötigt die Verunreinigungshülle und den Gegenionenzustand, um zu verstehen, warum.
Gegenioneffekte sind gut dokumentiert. In einem 2025 Rezension, Das M33-Peptid als TFA-Salz zeigte eine um 5–30 % höhere Zytotoxizität gegenüber normalen Bronchialepithelzellen als das Acetat-Gegenstück, und mit TFA formuliertes MOG-Peptid war grob mit dem Ausbruch einer Enzephalomyelitis verbunden 5 Tage früher bei vergleichbarer Inzidenz und Schwere (Biomoleküle, 2025-11-07). Eine separate Überprüfung ergab, dass Chlorid das am wenigsten wirksame der getesteten Anionen bei der Induktion einer helikalen Struktur in LL-37 war (Arzneimittel / Moleküle, 2020-12-03). Es handelt sich hierbei um formulierungsabhängige Beobachtungen, keine pauschale Aussage, dass jedes Gegenion unsicher ist.
Die Umsetzung bedeutet die Speicherung von Verunreinigungsretentionszeiten, relative Flächen und der Gegenionenaustauschzustand neben der Reinheitszahl. Für Validierungsstufen, ICH Q2(R2) Legt den Validierungsbereich und nicht die Peptidreinheitsgrenzen fest: Die Verunreinigungsprüfung muss den Meldeschwellenwert bis abdecken 120% der Spezifikationsgrenze, und die Reinheit nach Flächenprozent wird anhand validiert 80% des unteren bis 100% der oberen Spezifikationsgrenze (ICH Q2(R2), endgültige Richtlinie 2023-11-30).
Pillen 4: Chargenhistorie und losbezogene Analysezertifikate
Modellvertrauen ist eine Rückverfolgbarkeitseigenschaft, deshalb Losnummern, Die Verknüpfung von Analysezertifikaten und der Verlauf erneuter Tests gehören in den Datensatz und nicht nur in das Qualitätsmanagementsystem. Die ALCOA+-Erwartungen, die KI/ML-Pipelines nun erfüllen müssen, sind ein bereits bestehender GMP-Standard, der auf einen neuen Anwendungsfall erweitert wird, keine neue Regel, die für Models erfunden wurde. Die Datenherkunft wird als kritisches Problem eingestuft, da KI/ML in MES und LIMS integriert wird, und der digitale Thread ist definiert als die ununterbrochene Kette von Datenbeziehungen von der Rohstoffprüfung über die Herstellung bis zur endgültigen Produktfreigabe (Regulatorische Perspektiven für die KI/ML-Implementierung, PMC, 2025-06-16).
Für Trinkgeld: Behalten Sie den Verlauf der erneuten Tests und Tests bei, anstatt ihn zu überschreiben Geschäft Es. Ein ersetzter Wert mit Zeitstempel ist ein Beweis; ein ersetzter Wert ist eine Lücke.
Der Fehlermodus ist eine doppelt gezählte Kampagne. Drei mit derselben Charge durchgeführte Tests werden als drei unabhängige Beobachtungen erfasst, und das Modell behandelt eine Charge als drei, Das stärkt das Vertrauen in ein Ergebnis, das nie wiederholt wurde.
Pillen 5: Standardisierte Analyseergebnisse und maschinenlesbare Formate
Standardisierte Analyseergebnisse für Peptid-KI hängen von Formaten ab, die eine Pipeline ohne manuelle Bereinigung analysieren kann. Für die analytische Ebene existieren bereits maschinenlesbare Standards: mzML für Rohdaten der Massenspektrometrie, mzIdentML und mzTab zur Identifizierung und Quantifizierung, PX-XML für Übermittlungsmetadaten, SDRF-Proteomics für Proben- und Expositionsbeziehungen, und USI für stabile Spektrumidentifikatoren (Proteomik-Dateninfrastruktur).
Für die Reproduzierbarkeit ist außerdem der vollständige Methodenblock erforderlich. Zu den Parametern der HPLC-Methode gehört die Säulenchemie (typischerweise C18), Partikel- und Porengröße, Säulenabmessungen, mobile Phasen und Modifikatoren, Steigungsprogramm, Durchflussmenge (um 1.0 ml/min analytisch), Säulentemperatur, Detektionswellenlänge (typischerweise 214–220 nm für Peptide) und Injektionsmenge. Die Identität muss durch LC-MS oder MALDI-TOF mit intakter Masse mit beobachteter gegenüber theoretischer Masse und einem angegebenen ppm- oder Da-Akzeptanzfenster bestätigt werden, nicht allein durch HPLC (Phenomenex HPLC-Wissenszentrum, 2026-07-29).
Der Fehlermodus ist ein Datensatz mit der Aufschrift „Standard-RP-HPLC-Gradient“. Ohne den Methodenblock, Das Ergebnis kann nicht als Validierungsanker dienen, und ein Partner kann es nicht reproduzieren.
Vertraulichkeit: Teilen von Peptiddaten, ohne die Spur preiszugeben
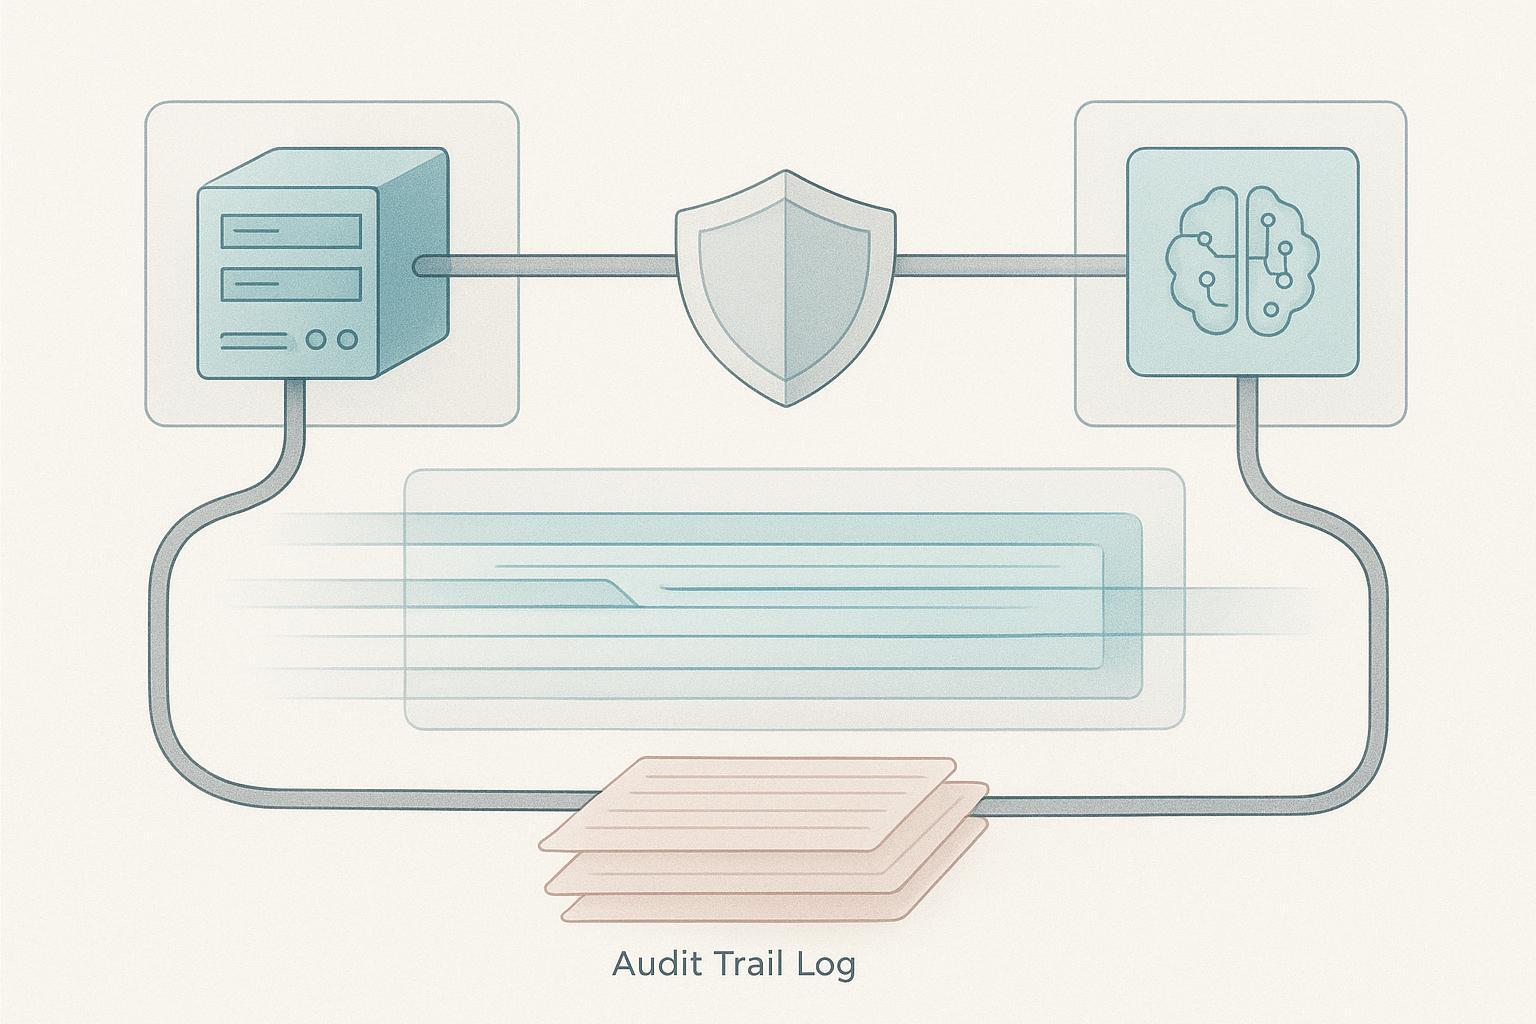
Das Vertraulichkeitsrisiko bei KI-Peptidpartnerschaften ist messbar, nicht theoretisch. A 2025 Eine Studie über neuronale Netze zur Arzneimittelentwicklung ergab, dass in einem Black-Box-Szenario nur Ausgabeprotokolle offengelegt werden, beispielsweise ein Modell, das als Webservice angeboten wird, Mitgliedschaftsinferenzangriffe identifizierten, welche chemischen Strukturen im Trainingssatz enthalten waren, und die Kombination mehrerer Angriffe erhöhte das Risiko (Die Veröffentlichung neuronaler Netze in der Arzneimittelforschung könnte die Vertraulichkeit gefährden, 2025-03-26). Die Autoren stellen fest, dass Moleküle aus Minderheitsklassen stammen, oft die wertvollsten in der Arzneimittelforschung, sind besonders gefährdet, und dass einzigartige Strukturen, die sich von etablierten Bibliotheksverbindungen unterscheiden, proprietären Leitstrukturen oder neuartigen Gerüsten in der Entwicklung entsprechen können.
Die operative Reaktion ist ein abgestuftes Zugriffsmodell und nicht eine einzelne Entscheidung zur Datenfreigabe. Sponsoren führen interne Aufzeichnungen; Der Partner erhält anonymisierte oder gehashte Darstellungen, sofern die Modellierungsaufgabe dies zulässt; Nur aggregierte Ausgaben verlassen die Zusammenarbeit. Vertragliche Grenzen dessen, was der Partner einbehalten darf, plus ein Audit-Trail für jede Abfrage des gemeinsam genutzten Satzes, Schließen Sie den Kreis.
Schlüssel zum Mitnehmen: Durch die De-Identifizierung wird das Leckrisiko bei strukturell unterschiedlichen Peptiden verringert, jedoch nicht beseitigt, Tiering und Abfrageprüfung haben also das Gewicht, das Maskierung allein nicht kann.
Wissenschaftliche Validierung: Ein Betriebsprotokoll, Kein Prinzip
Validierung ist kein Prinzip, mit dem Sie einverstanden sind. Es ist eine Sequenz, die Sie ausführen: zuerst die orthogonale Bestätigung, dann unabhängige Replikation, Anschließend wird jeder modellbezogene Wert mit den analytischen Rohdaten abgeglichen, aus denen er stammt. Das Überspringen des dritten Schritts ist der häufigste Fehler, weil eine abgeglichene Zahl und eine nicht abgeglichene Zahl in einer Trainingstabelle identisch aussehen.
Definieren Sie das orthogonale Paar pro Anspruchstyp, bevor Sie etwas generieren. Für Identität, Paar intakte Masse mit einer zweiten, mechanistisch andere Methode als eine wiederholte Injektion am selben Instrument. Für Aktivität, Kombinieren Sie eine biophysikalische Bindungsauslesung mit einer zellbasierten funktionellen Auslesung, weil die beiden unterschiedliche Fragen beantworten.
Für die Replikation muss eine unabhängig synthetisierte Charge verwendet werden, keine Wiederholung des gleichen Materials. Die zweimalige Durchführung desselben Tests mit derselben Charge misst die Präzision des Geräts, keine Verallgemeinerung. A 2025 Eine systematische Überprüfung von Epitop-Vorhersagemethoden ergab, dass viele aktuelle Ansätze unter einer Überanpassung an ihre Trainingsdatensätze leiden, was die Übertragungsfähigkeit auf neue Ziele drastisch einschränkt (npj-Impfstoffe, 2025-08-30). In derselben Überprüfung wird festgestellt, dass nicht alle Bindemittel immunogen sind: Ein hochrangiges Epitop kann in vitro Antikörper binden, in vivo jedoch nicht die beabsichtigte Reaktion hervorrufen, und die Genauigkeit eines Benchmarks überträgt sich nicht auf die Anzeige, Zelllinie, oder der Zielkontext ist unterschiedlich.
Das ist der Fehlermodus, gegen den man entwerfen muss. Ein Validierungssatz, der aus derselben Kampagne wie der Trainingssatz stammt, misst das Auswendiglernen, keine Verallgemeinerung.
Die Benchmark-Lücke: Was die Standardisierung immer noch nicht beheben kann
Standardisierung ist notwendig, aber nicht ausreichend. Die Maßstäbe des Fachgebiets sind neu und eng, Und noch kann keine Scorecard messen, was sie zu messen vorgibt.
PepBenchmark, der im April veröffentlichte standardisierte Peptid-ML-Benchmark 2026 und am ICLR präsentiert 2026, Abdeckungen 29 Canonical-Peptid Plus 6 nicht-kanonische Peptid-Datensätze übergreifend 7 Gruppen, mit einer einheitlichen Vorverarbeitungspipeline und einer Rangliste, die vier Methodenfamilien umfasst: Fingerabdruck, GNN, PLM, und LÄCHELT. Die Autoren stellen klar und deutlich fest, dass frühere Arbeiten „durch das Fehlen standardisierter Benchmarks behindert wurden“ und unter „Qualitätsproblemen litten, die bei Ad-hoc-Pipelines häufig vorkommen“. Das ist ein echter Fortschritt, und es ist auch eine schmale: 35 Datensätze, ein Maßstab, eine Veröffentlichung.
Die ehrlichen Grenzen sind für die Planung wichtiger als die Überschrift. Keine Umfrage gibt einen einzigen vertretbaren FAIR-Adoptionsprozentsatz für Biopharma R an&D, und keine Studie zählt den Anteil der AI-Papiere zur Arzneimittelentwicklung mit Lecks oder Reproduzierbarkeitsfehlern. Jede Bereitschafts-Scorecard ist daher eine Beurteilungshilfe, not a measurement.
⚠️ Warnung: Behandeln Sie einen Bereitschaftswert als strukturierten Gesprächseinstieg, not a validated metric. Wenn ein Partner fragt, woran Ihre Punktzahl gemessen wird, Die richtige Antwort lautet heute: „Unsere eigenen Kriterien.“,„kein veröffentlichter Standard.
Der Außenrahmen kommt, obwohl. Der Januar der FDA 2025 Der Leitlinienentwurf zu KI bei regulatorischen Entscheidungen schlägt eine risikobasierte Glaubwürdigkeitsbewertung vor, die an einen angegebenen Nutzungskontext gebunden ist. Es handelt sich um einen Entwurf, nicht zur Umsetzung, und es regelt eher Einreichungen als Entdeckungen. Auch so, Es weist auf die Frage hin, zu deren Beantwortung ein Bereitschaftsprogramm erstellt werden sollte: what is this model for, und welche Beweise machen die Ausgabe für diesen Zweck glaubwürdig??
Erste Schritte: Ein 30-tägiger Peptiddaten-Bereitschaftspass
Peptiddaten-Workflows für die KI-Wirkstoffforschung werden am schnellsten getestet, indem zwanzig Peptiddatensätze nach dem Zufallsprinzip gezogen und jeder einzelne anhand der fünf Säulen bewertet wird. Das ist eine Fünf-Minuten-Entscheidung, und es klärt normalerweise die Frage, ob ein Programm für eine Partnerschaft bereit ist. Die meisten Teams stellen fest, dass eine Handvoll Datensätze sauber sind, eine größere Gruppe ist teilweise vollständig, und einige können überhaupt nicht rekonstruiert werden.
Für jedes Feld, das fehlschlägt, Entscheiden Sie, ob es sich bei der Lücke um ein Erfassungsproblem oder ein Verknüpfungsproblem handelt. Ein Erfassungsproblem bedeutet, dass die Daten nie aufgezeichnet wurden, Die Lösung besteht also in einer Änderung dessen, was das Team auf der Bank sammelt. Ein Verknüpfungsproblem bedeutet, dass die Daten irgendwo vorhanden sind, aber nicht mit vielen verknüpft sind, eine Methode, oder eine Testauslesung, Die Lösung besteht also aus einem Bezeichner und einem Join, kein neues Experiment. Die beiden haben unterschiedliche Besitzer und unterschiedliche Zeitpläne, und die Behandlung eines Verknüpfungsproblems als Erfassungsproblem verschwendet Monate.
Führen Sie dann ein Peptid von Ende zu Ende durch die gesamte Kette: Identitätsdatensatz, Chargenbezogenes Analysezertifikat, maschinenlesbare Analysedatei. Dokumentieren Sie jeden Punkt, an dem ein Mensch manuell eingreifen musste. Diese Interventionsliste ist der eigentliche Umfang des Bereitschaftsprojekts.
Die allgemeine Bedenken bestehen darin, dass hierfür ein Austausch der Plattform erforderlich ist. In den meisten Fällen ist dies nicht der Fall. Es erfordert Disziplin auf Feldebene bei den Aufzeichnungen, die das Team bereits erstellt.
Nächster Schritt: Führen Sie den Bewertungsdurchlauf mit zwanzig Datensätzen durch und führen Sie die Interventionsliste einer Überprüfung der technischen Datenbereitschaft durch, wo die Lücken auf konkrete Korrekturen abgebildet werden.
Häufig gestellte Fragen
Was macht eine Peptidsequenz und einen Modifikationsdatensatz eindeutig??
Eine eindeutige Aufzeichnung benennt die genaue chemische Struktur, keine Abkürzung, die ein Leser interpretieren muss. Die Referenzbehandlung der Peptidstrukturnotation behandelt eine verlustfreie chemische Darstellung als primären Datensatz, wobei HELM für polymerbewusste Strukturen und SMILES für Diagrammmodelle auf Atomebene verwendet wird, InChI oder InChIKey als Deduplizierungs- und Identitätsschlüssel, Zyklisierung und Vernetzung als explizite Verbindungsobjekte geschrieben, und nicht-natürliche Reste, die in Mehrbuchstabencodes mit Kleinbuchstaben für D-Aminosäuren geschrieben sind. Anmerkung zur Änderung auf Restebene, wie von MAP verwendet, sorgt dafür, dass sich eine Lactambrücke von einem Disulfid unterscheidet. Ein Datensatz, in dem „modifiziertes Peptid“ ohne dieses Detail steht, sieht sauber aus, ist aber nicht KI-bereit.
Ist HELM oder SMILES der bessere Primärdatensatz??
Keines von beiden ist allgemein besser; Die Auswahl folgt dem Modell, das den Datensatz konsumiert. HELM bewahrt die Topologie auf Polymerebene und verarbeitet nicht-natürliche Monomere und Verbindungsobjekte sauber, was für sequenzbewusste und makrozyklische Arbeit geeignet ist. SMILES liefert ein Diagramm auf Atomebene, das die meisten grafischen neuronalen Netze und Cheminformatik-Toolkits direkt lesen. Programme, die beides benötigen, speichern einen als primären Datensatz und generieren den anderen, mit InChIKey als Verbindungsschlüssel, sodass dasselbe Molekül nie zweimal gezählt wird.
Wie viel Assay-Kontext ist ausreichend??
Genug, dass ein anderes Labor die Messung wiederholen und die Zahl interpretieren könnte. Zumindest: Assay-Typ und Anzeige, Ziel und Konstruktion, Zelllinie oder Matrix, Konzentrationsbereich, Inkubationsbedingungen, Nachweismethode, und die Einheiten. A 2025 Eine systematische Überprüfung der Epitop-Prädiktoren ergab, dass ein Epitop mit dem höchsten Rang in vitro Antikörper binden kann, in vivo jedoch nur eine geringe Immunogenität aufweist, und diese Genauigkeit wird beim Auslesen nicht übertragen, Zelllinie oder Zielkontext sind unterschiedlich. Ein Bindungswert ohne Kontext kann mit nichts zusammengefasst werden.
Ist eine einzelne Reinheitszahl jemals akzeptabel??
Nur als Überschrift, niemals als Rekord. ICH Q2(R2)Die Anforderungen an den Validierungsbereich legen die Meldung von Verunreinigungen vom Schwellenwert bis zu fest 120% der Spezifikationsgrenze, und Reinheitsfläche in Prozent ab 80% Zu 100% der Spezifikationsgrenzen, mit Nachweis- und Quantifizierungsgrenzen um Signal-Rausch-Verhältnisse von ungefähr 3:1 Und 10:1. Daten zu Peptidverunreinigungen und Chargenhistorie, die nur „98 % rein“ enthalten, verbergen welche Verunreinigungen, auf welchem Niveau, mit welcher Methode. Behalten Sie die Nummer, Befestigen Sie dann das Profil dahinter. Peptidproduktion Um
Wie können wir Strukturen mit einem Partner teilen, ohne die Hauptserie preiszugeben??
Teilen Sie das Modell oder die abgeleiteten Features und nicht den rohen Trainingssatz, und testen Sie, was die Ausgabe verrät. Mitgliedschaftsinferenzangriffe, die Trainingsmoleküle aus einem bedienten Modell wiederherstellen, identifizieren Trainingsmoleküle allein aus Ausgabeprotokollen, und Moleküle der Minderheitsklasse und neuartiger Gerüste sind am anfälligsten, wobei kombinierte Angriffe das Risiko weiter erhöhen. Wenn ein Partner die Daten selbst benötigt, Verwenden Sie eine kontrollierte Umgebung mit einem vereinbarten Funktionsumfang und einem Audit-Trail anstelle einer Dateiübertragung.
Kann ein Modell ohne unabhängige Charge validiert werden??
NEIN. Ein Modell, das nur für Lose validiert wurde, für die es bereits eine Speicherung von Berichten gesehen hat, keine Verallgemeinerung. Halten Sie mindestens ein Los pro Programm zurück, Idealerweise aus einer anderen Synthesekampagne, und lassen Sie es bis zur endgültigen Bewertung unberührt. Wenn kein eigenständiges Los vorhanden ist, Die ehrliche Aussage ist, dass das Modell in sich konsistent ist, nicht validiert.
Gilt der Leitlinienentwurf der FDA für Arbeiten in der Entdeckungsphase??
Nicht direkt, Aber es ist die klarste verfügbare Aussage über den Standard, an den Sie letztendlich gebunden sein werden. Der Januar der FDA 2025 Der Leitlinienentwurf zu KI bei regulatorischen Entscheidungen schlägt eine risikobasierte Glaubwürdigkeitsbewertung vor, die an einen angegebenen Nutzungskontext gebunden ist. Es handelt sich um einen datierten Entwurf 6 Januar 2025 und dient nicht der Umsetzung. Discovery-Teams, die den Nutzungskontext jetzt dokumentieren, müssen ihn später nicht rekonstruieren.
Schlüssel zum Mitnehmen: Ein Bereitschaftsanspruch ist nur dann vertretbar, wenn er die Datensatzfelder benennt, die Sharing-Architektur und das Validierungsprotokoll, nicht, wenn eine Reinheitszahl angegeben wird.
Abschluss
Die Bereitschaft ist eine Eigenschaft der Aufzeichnung, nicht vom Modell, und das sind die Testpeptiddaten-Workflows für die KI-Wirkstoffforschung, mit denen jetzt jedes Partnerschaftsgespräch konfrontiert wird. Die fünf Säulen, eindeutige Sequenz- und Modifikationsnotation, Assay-Kontext, der mit dem Ergebnis wandert, Verunreinigungsprofile statt einer einzelnen Reinheitszahl, Chargenbezogene Analysezertifikate, und maschinenlesbare standardisierte Analyseausgabe, sind die Checkliste. Durch eine Vertraulichkeitsarchitektur und ein schriftliches Validierungsprotokoll können Sie diese Aufzeichnungen weitergeben, ohne den Lead abzugeben.
Die Benchmark- und Regulierungsrahmen sind noch im Entstehen: PepBenchmark 2026 ist früh, und der Leitlinienentwurf der FDA ist noch nicht für die Umsetzung verfasst. Ein jetzt erstelltes Bereitschaftsprogramm beantwortet eine Frage, die Partner später formeller stellen werden, Bauen Sie es also so auf, dass es erneut bewertet wird, anstatt es nur einmal zu zertifizieren. Dieser Leitfaden ist eine Beurteilungshilfe, not a measurement. Es gibt keinen vertretbaren feldweiten FAIR-Annahme-Prozentsatz oder eine Leckage-Defekt-Zählung, Daher unterstützt eine Scorecard hier eine Entscheidung, anstatt sie zu regeln.
MOL Changes veröffentlicht als Peptidanbieter.
Finden Sie heraus, wo Ihre Peptiddatensätze am Modell eines Partners scheitern würden. Eine technische Überprüfung der Datenbereitschaft ordnet Ihre Peptiddatensätze den fünf Säulen zu und klassifiziert jede Lücke als Erfassungsproblem oder Verknüpfungsproblem. Fordern Sie eine Überprüfung der Datenbereitschaft an mit unserem Analyseteam.