Waarom de $300 Million Benchmark herkadert AI bij het ontdekken en ontwikkelen van peptiden
GenScript's september 2026 aandeel plaatsing ongeveer gezet $300 miljoen achter één enkele claim: dat het knelpunt in AI bij de ontdekking en ontwikkeling van peptiden vooraan in de pijplijn zit, niet de achterkant. Het bedrijf heeft uitgegeven 77,126,000 nieuwe aandelen voor HK$30,50 per stuk aan ten minste zes onafhankelijke investeerders, netto ongeveer HK $ 2,33 miljard ophalen (de voorwaarden van de plaatsing, 2026-09-17). De veelvuldig herhaalde “300 miljoen dollar” is een afgeronde karakterisering van die verhoging en niet een cijfer uit de aanvraag zelf.
Waar het geld terechtkomt, is belangrijker dan de kop. Door de uitsplitsing van de financieringstoewijzing gaat ongeveer 1,63 miljard HK$ naar de capaciteit en infrastructuur van AI-gestuurde geneesmiddelenontdekkingsplatforms, ongeveer HK$ 470 miljoen aan R&D, digitale workflow-integratie en wereldwijde expansie, en ongeveer HK$ 230 miljoen voor algemene bedrijfsdoeleinden (2026-09-17). Het genoemde automatiseringsdoel is een ‘gen-naar-eiwit’-workflow die loopt van door AI gegenereerde sequenties via biologische constructies tot experimentele validatie, gebouwd rond een “4-daagse AI-to-Biology Validation Engine” en een doel dat ongeveer overeenkomt 60% van de mondiale productiecapaciteit zal tegen het einde van de maand door AI-automatisering worden aangedreven 2026. De Tamarinde Bio-binding wordt beschreven als het verbinden van moleculair AI-ontwerp met snelle laboratoriumvalidatie (2026-08-05).
Eén sourcingnota vóór de analyse: de plaatsings- en toewijzingscijfers zijn terug te voeren op één enkele upstream plaatsingsaankondiging, opnieuw gerapporteerd via financiële kanalen, dus ze zijn één bron, niet vier onafhankelijke bevestigingen. In de rest van dit artikel worden de overdrachtspunten gecontroleerd waar een gefinancierde voorspelling wel of niet testmateriaal wordt.
Sleutel afhaalmaaltijd: Het kapitaal is gericht op het segment vóór experimentele validatie, wat betekent dat de maatstaf om te beoordelen niet de prestatie van het model is, maar wat de synthese overleeft, zuivering en identiteitsbevestiging.
De conventionele visie: AI heeft de tijdlijnen voor het ontdekken van peptiden al gecomprimeerd
Het mainstream standpunt is dat generatief ontwerp, optimalisatie van meerdere parameters, en high-performance computing hebben de tijdlijn van ontwerp tot kandidaat al ineengestort, en dat leveranciersplatforms nu end-to-end AI-peptidegeneesmiddelenontdekking mogelijk maken. GenScript stelt dat de ‘Gene-to-Protein’-workflow voor dat doel wordt gebouwd, langszij het gestelde automatiseringsdoel dat ongeveer 60% van zijn mondiale productiecapaciteit zal tegen het einde van de maand door AI-automatisering worden aangedreven 2026. De Tamarind Bio-koppeling wordt gepresenteerd als een verbinding tussen AI-moleculair ontwerp en snelle laboratoriumvalidatie, en de federatieve leerregeling onder Lilly TuneLab zorgt ervoor dat aangesloten biotechbedrijven experimentele resultaten bijdragen om modellen te verbeteren die de ontwikkelbaarheid en ADMET-eigenschappen voorspellen.
De weergave is populair omdat deze richtingsgetrouw en commercieel leesbaar is. Een decennium van echte vooruitgang op het gebied van structuurvoorspelling en eigendomsmodellering gaf de claim zijn basis, en leveranciers brengen de hele keten nu als één product op de markt. De eigen platformvergelijking van de leverancier meldt een groter dan 95% synthese succespercentage tegen a 75% branchegemiddelde, met reeksen tot 200 aminozuren tegen een aangegeven 4 naar 50 aminozuurmarktgemiddelde. Deze cijfers zijn door de leverancier opgegeven, niet onafhankelijk geverifieerd.
Waar de conventionele visie breekt: Drie overdrachtspunten
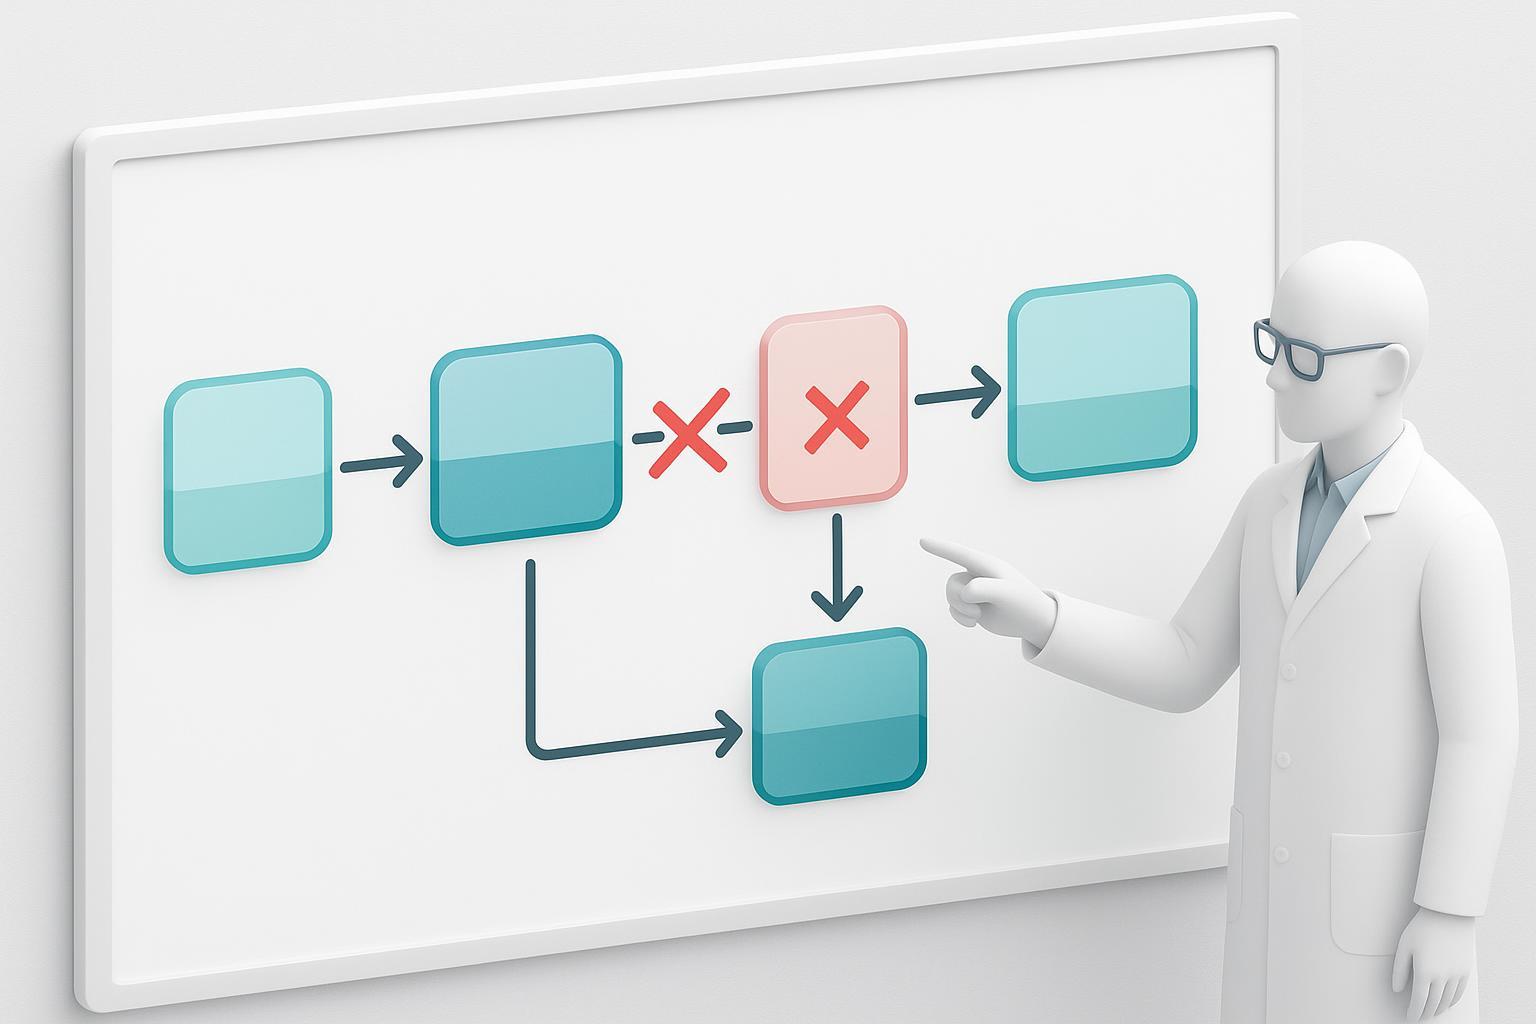
De pijpleiding is niet continu, en de discontinuïteiten ervan zijn waar kandidaten sterven. Een modelscore, een syntheserun, en een testuitlezing zijn drie afzonderlijke systemen met drie afzonderlijke storingsmodi, en de conventionele visie brengt ze samen in één vloeiende lijn van reeks tot resultaat.
De eerste breuk is de inflatie van het evaluatieprotocol. Gerapporteerde meetgegevens worden vaak geciteerd zonder onderscheid te maken tussen een willekeurig gesplitste testset en een structureel ongelijke testset, een kopnummer kan dus als gevalideerde prestatie worden gelezen als het alleen weergeeft hoe goed een model interpoleert binnen de bekende reeksruimte. De recente evaluatie van datagestuurd peptideontwerp maakt deze kritiek direct: gerapporteerde discriminatiescores kunnen aanzienlijk dalen zodra de testset wordt opgesplitst per scaffold in plaats van willekeurig, dat is de splitsing die lijkt op een echt nieuwe kandidaat.
De tweede breuk is de haalbaarheid van syntheses, wat geen modeluitvoer is. Wanneer AI-genomineerde sequenties de hars bereiken, de CDMO-overdrachtchecklist noemt de volgende faalmodi: onvolledige Fmoc-ontscherming, koppeling van verzwakking en sterische hinder door aggregatie op hars, N-1- en N-2-deletiesequenties van mislukte koppelingen, lage ruwe zuiverheid, en weinig herstel. Lengte verergert het probleem. De eigen richtlijnen van GenScript stellen dat peptiden langer zijn dan 100 aminozuren zijn “uiterst moeilijk te synthetiseren” en worden geval per geval behandeld via fragmentatie en ligatie, per de eigen syntheserichtlijnen van de leverancier.
De derde breuk is een assayartefact. Colloïdale aggregaten van submicron kunnen niet-specifiek adsorberen aan platen en sensorchips, het produceren van kunstmatige nanomolaire signalen die verdwijnen tegen een monodisperse controle.
Bij de kwaliteitscontrole van de peptidesynthese komen deze breuken naar boven. Alle drie delen ze één hoofdoorzaak: de conventionele visie behandelt een voorspelling als resultaat.
⚠️Waarschuwing: Een modelgerapporteerde metriek is pas gevalideerd als deze een splitsing overleeft die de echte nieuwigheid van de sequentie weerspiegelt.
Wat de gegevens feitelijk laten zien over door AI ontworpen peptiden
Dezelfde cijfers die worden aangehaald als bewijs van het succes van AI-gedreven ontwerpen ondersteunen een beperktere bewering: AI is een triage- en prioriteringslaag waarvan de output een hypothese is, geen resultaat. Lees de evaluatievoorwaarden en het plafond wordt zichtbaar.
De benchmarkrapporten voor alleen opeenvolging van ontwikkelbaarheid 91.09% hemolyse, 86.30% niet-vervuilend, En 75.56% oplosbaarheidsnauwkeurigheid onder door gelijkenis gecontroleerde splitsingen (de sequentie-only ontwikkelbaarheidsbenchmark, 2023-11). De gerapporteerde nauwkeurigheid van PeptideBERT komt binnen een compatibel bereik terecht op overlappende eindpunten, ongeveer 86.05% hemolyse, 88.37% niet-vervuilend, En 70.02% oplosbaarheid, wat eerder een gedeeltelijke, onafhankelijke bevestiging is dan een echo (PeptideBERT-voordruk, 2023-09). Oplosbaarheid is in beide het zwakste eindpunt.
Het CamSol-PTM-oplosbaarheidswerk laat zien waarom dit belangrijk is voor de screening van peptide-ontwikkelbaarheid: gemiddelde Pearson-correlatie van 0.72 op niet-natuurlijke aminozuurpeptiden, vallen naar 0.58 op GLP-1-varianten en 0.60 op de generalisatieset, waarbij twee ontwerpen zijn uitgesloten als niet-produceerbaar (CamSol-PTM, Natuurcommunicatie, 2023-11). Een model kan de oplosbaarheid goed rangschikken en toch reeksen nomineren die niet gemaakt kunnen worden.
Een reeks met drie poorten vervangt de enkele betrouwbaarheidsscore: computationele triage, vervolgens een haalbaarheidsonderzoek voor synthese, vervolgens analytische vrijgave. Bij elke poort komt een kandidaat alleen vooruit op basis van experimenteel bewijs, dat is wat de validatie van door AI ontworpen peptiden in de praktijk zou moeten betekenen.
De betere aanpak: Controleer de vrijgavegegevens, Niet de modelstatistieken
Evalueer leveranciers van AI-peptiden op basis van hun analytische releasedocumentatie, niet op de modelprestaties die zij rapporteren. Het principe achter die verschuiving is eenvoudig: een voorspelling is slechts zo goed als het materiaal dat een leverancier u kan leveren met een traceerbaar analytisch record erachter. Uit de bovenstaande overdrachtspunten volgen vier vereisten.
-
Vraag naar de evaluatievoorwaarde achter elke prestatieclaim. Een willekeurige splitsing en een structureel ongelijke testset leveren zeer verschillende getallen op, en slechts één ervan vertelt je hoe het model zich gedraagt op basis van de chemie die het nog niet heeft gezien.
-
Orthogonale identiteitsbevestiging vereisen, geen enkele massacontrole. De voorgestelde orthogonale validatiesuite combineert RP-HPLC op C18 en C4 met ESI-MS of MALDI-TOF, voegt circulair dichroïsme toe over ver-UV 190 naar 260 nm, DLS of SEC-MALS met een polydispersiteitsindex eronder 0.15, en een Ellmans-test voor gratis thiol onder 0.05 mol SH/mol peptide. Dit zijn door de uitgever voorgestelde criteria, geen mandaat van een normalisatie-instantie, Beschouw ze dus als een startspecificatie om over te onderhandelen.
-
Vereist traceerbaarheid van partij tot partij en een vastgelegde conventie. De massabalansconventie dat is het doelpeptide, peptide-onzuiverheden, tegenion en water aan 100% is wat een zuiverheidscijfer tussen partijen vergelijkbaar maakt.
-
Peptidesynthese Vereist opschalingsbewijs van mg naar kg, geen demonstratie op één schaal. De gepubliceerde schaalbereiken beschrijven leveranciersspecificaties in plaats van onafhankelijke benchmarks, vraag dus van welke schaal de vrijgavegegevens daadwerkelijk afkomstig zijn.
Voor Tip: Vraag eerst naar het splitprotocol voordat u naar het prestatienummer vraagt. Een leverancier die de testset kan beschrijven, kan doorgaans ook de testgegevens beschrijven.
Leveranciers zoals MOL Changes publiceren dergelijke analytische releasedocumentatie, waardoor de audit een documentverzoek wordt in plaats van een mogelijkheidsschatting. Dit is waar de kwaliteitscontrole van de peptidesynthese niet langer een marketingclaim is, maar een reeks bestanden wordt die u kunt lezen.
Hoe u dit kunt toepassen: Evaluatiereeks van een koper
Vraag het analytische releasepakket aan voordat u het mogelijkhedendek doorneemt. Die ene omkering verandert het gesprek van wat een model kan voorspellen naar wat een leverancier kan bewijzen, en het is de snelste manier om leveranciers die materiaal hebben gevalideerd te sorteren van leveranciers die dia's hebben gevalideerd.
-
Vraag naar het evaluatieprotocol achter elke gerapporteerde modelmetriek. Vraag de train/test split methodologie aan, de uitgehouden setcompositie, en of het gerapporteerde cijfer afkomstig is van retrospectieve scoring of prospectieve synthese. Vraag het dezelfde dag, en het antwoord vertelt u of het getal een benchmark of een marketingmiddel is.
-
Dien een bekend-moeilijke reeks in als haalbaarheidsonderzoek. Een hydrofoob of aggregatiegevoelig stuk onthult meer dan een cataloguspeptide ooit zal doen. Peptiden voorbij 100 aminozuren worden geval per geval behandeld onder de eigen synthesebegeleiding van de leverancier, kies dus een sonde dichtbij die grens in plaats van binnen het comfortabele bereik. Dagen tot weken.
-
Controleer het analytische pakket op basis van orthogonale bevestiging, geen enkel LC-MS-spoor. Eén massaspectrum bevestigt massa, niet op volgorde. Vraag hoe de leverancier het voorgestelde orthogonale validatiepakket toepast en welke methoden routinematig zijn en welke afzonderlijk worden geciteerd.
-
Vraag lot-tot-lot-gegevens op en de massabalansconventie die wordt gebruikt om het netto peptidegehalte te rapporteren. Dit is waar de massabalansconventie van belang is: Synthetische peptiden zuiverheid uitgedrukt tegen peptidemassa en zuiverheid uitgedrukt tegen totaal drooggewicht zijn verschillende claims, en slechts één daarvan overleeft de opschaling.
-
Bevestig bewijs van opschaling van milligram tot kilogram met zuiverheid volgens specificatie. De gepubliceerde schaalbereiken laten zien waar een leverancier reclame voor maakt; de lotgeschiedenis laat zien wat het herhaalt.
Stap
Artefact gevraagd
Wat het vaststelt
Typische inspanning
1
Evaluatieprotocol en splitmethodologie
Of de statistiek prospectief of retrospectief is
Dezelfde dag
2
Haalbaarheidsonderzoek naar een moeilijke reeks
Of ontwerpclaims de synthese overleven
Dagen tot weken
3
Orthogonaal bevestigingspakket
Sequentie-identiteit voorbij een enkel spoor
Dagen
Lot-tot-lot-gegevens en massabalansconventie
Of zuiverheidsclaims tussen partijen vergelijkbaar zijn
Weken
5
Bewijs opschalen, mg tot kg
Of de specificatie standhoudt naarmate de batchgrootte groeit
Langere termijn
Houd bij of zuiverheid en identiteit over de kavels heen gelden, niet of het eerste lot geslaagd is. Een leverancier zonder haalbaarheidsonderzoek of lotgeschiedenis wordt niet gediskwalificeerd, maar het is niet geverifieerd, en je moet die onzekerheid in de beslissing verdisconteren.
Waar dit argument het zwakst is
De hier voorgestelde standaard voor analytische afgifte is geen wettelijke vereiste, en een leverancier die hieraan voldoet is daardoor geen betere wetenschappelijke partner. Het is een zorgvuldigheidskader aan de koperszijde, samengesteld op basis van gepubliceerde praktijk in plaats van op basis van bindende richtlijnen. De orthogonale validatiesuite die in de vorige sectie is beschreven, is voorgesteld door de uitgever, en geen enkele toezichthouder dwingt een sponsor om het uit te voeren voordat de output van een ontwerpplatform wordt geciteerd.
Dat onderscheid is het belangrijkst bij vroeg verkennend werk. Als het doel het rangschikken van hypothesen is, zodat een onderzoeksteam deze kan triageen, modelmetrieken kunnen volkomen voldoende zijn, en het eisen van een volledige release-audit in dat stadium staat niet in verhouding tot waar het werk voor is. De audit verdient zijn geld wanneer een voorspelling op het punt staat testmateriaal te worden.
Eén eerlijke beperking: de kritiek op het evaluatieprotocol berust deels op benchmarkcijfers die in deze onderzoeksronde niet opnieuw konden worden geverifieerd. Als deze cijfers bij strikte splitsingen minder verslechteren dan gerapporteerd, de kritiek verzwakt, hoewel de overdrachtspunten die het beschrijft waarneembaar blijven in de gepubliceerde synthese- en zuiveringspraktijk.
Het standpunt is dat voorspellingen moeten worden gecontroleerd, niet afgewezen. Het opeenvolgen van bewijsmateriaal is het argument, rekenmethoden niet afwijzen.
Maar een sneller ontwerp creëert niet nog steeds echte waarde?
Ja, en niets in dit argument betwist dit. Het comprimeren van een zoekruimte en beslissen welke reeksen de moeite waard zijn om te maken is echt werk met echte besparingen, en dat is waar AI bij de ontdekking en ontwikkeling van peptiden zijn plaats heeft verdiend.
Het duidelijkste gepubliceerde voorbeeld is het door AlphaFold gescreende onderzoek naar actief leren, die melding maakt van herstel 50% van alle bindmiddelen die gebruiken 15% van de vragen die een uitputtende steekproef zou vereisen, een verbetering van 3,3x ten opzichte van willekeurige steekproeven. Dat is een aanzienlijke winst in de efficiëntie van zoekopdrachten, en het is de moeite waard om precies te zijn over wat het meet: hoeveel kandidaten een model moet beoordelen om een shortlist te verkrijgen. Het resultaat is een preprint en is niet door vakgenoten beoordeeld, Beschouw de omvang dus als voorlopig en niet als definitief.
Het meningsverschil is kleiner dan het lijkt. Query-efficiëntie is een winst in de ontwerpfase. Hierin staat welke reeksen u moet bestellen. Het zegt niets over de vraag of de bindmiddelen die u terugkrijgt, volgens specificatie kunnen worden gesynthetiseerd, gezuiverd tot een aanvaardbaar onzuiverheidsprofiel, of bevestigd door een orthogonale methode. Een shortlist die deze stappen niet kan voltooien, is een snellere route naar een mislukte partij.
Wat als we al in een AI-ontwerpplatform hebben geïnvesteerd??
De investering is niet verloren gegaan, en de transitie is eerder additief dan een herstart. Een ontwerpplatform blijft doen waar het goed in is: kandidaten rangschikken, het signaleren van verplichtingen, en het verkleinen van een grote reeksruimte tot een shortlist die de moeite waard is om te maken. Wat verandert is dat de organisatie stroomafwaarts een haalbaarheids- en release-poort toevoegt, waarbij elke kandidaat op de shortlist wordt beoordeeld op synthesebaarheid, zuiveringsgedrag, en orthogonale identiteitsbevestiging voordat deze testcapaciteit verbruikt. De twee lagen zijn complementair, niet concurrerend.
De praktische volgorde is eenvoudig. Bewaar het model. Voeg de sonde toe. Vereist vervolgens het volledige analytische pakket voor de eerste drie kandidaten voordat u de relatie opschaalt naar routinewerk. Die laatste stap is van belang omdat het een leveranciersrelatie omzet in een gedocumenteerde relatie: je leert hoe de voorspellingen van het platform zich gedragen in vergelijking met je eigen releasecriteria, op uw eigen reeksen, in plaats van tegen een benchmarkset.
Waar een transitiemetriek zou helpen, houd er rekening mee dat dit soort cijfers per bron verschillen, behandel dus elk afzonderlijk getal met voorzichtigheid. Het federatieve leerarrangement is een nuttige illustratie van het onderliggende principe: ontwerpresultaten en experimentele resultaten verbeteren elkaar wanneer ze in een lus worden aangesloten in plaats van in afzonderlijke systemen te worden bewaard.
Hoe reageert u op leveranciers die sterke gepubliceerde benchmarks aanhalen?
Maak gebruik van de methodologie van de benchmark in plaats van het aantal ervan te betwisten. Een hoge score onder een willekeurige treintestsplitsing en een lagere score onder een scaffold- of single-linkage-splitsing zijn beide correcte metingen van verschillende dingen, en de nuttige vraag is welke meting de claim van de verkoper feitelijk beschrijft. Dat is een vraag over de reikwijdte, niet over eerlijkheid.
De recente review van datagedreven peptideontwerp maakt dit concreet: willekeurige splitsingen zorgen ervoor dat bijna dubbele analogen aan beide zijden van de partitie zitten, een model kan dus goed scoren door nauwe verwanten van zijn trainingsset te herkennen in plaats van door te generaliseren naar een nieuwe chemische reeks. Scaffold- en single-linkage-splitsingen verwijderen die kortere weg en produceren lager, eerlijkere cijfers.
Het CamSol-PTM-oplosbaarheidswerk laat hetzelfde effect zien op het eindpuntniveau. De gerapporteerde prestatiegemiddelden liggen rond 0.72 over de hele benchmark, maar daalt tot ongeveer 0.58 op GLP-1-varianten, een smallere en hardere reikwijdte. Beide figuren zijn echt. Het is ook niet het hele verhaal.
Voor AI-ontworpen peptidenvalidatie, de praktische zet is om te vragen welke splitsing, welk eindpunt, en welke chemische reikwijdte het aantal produceerde. Leveranciers die hun split-methodologie publiceren, zijn gemakkelijker te evalueren, niet moeilijker, omdat de claim arriveert met de grenzen eraan.
De verschuiving die de industrie nodig heeft
De benchmark GenScript's $300 miljoen verhogingssets moeten worden gemeten in analytische vrijgavecapaciteit, geen modelstatistieken. Dat is het argument waarnaar dit stuk is opgebouwd, en het volgt rechtstreeks uit de eigen formulering van de loonsverhoging door het management: het kapitaal breidt het deel uit vóór experimentele validatie, terwijl de synthese wordt uitgevoerd, analytische nauwkeurigheid, en de steriele productiecapaciteit blijven erdoor onveranderd.
Wat moet veranderen is een marktnorm, niet de praktijk van één enkele leverancier. Leveranciers van AI-gebaseerde peptiden moeten naast prestatieclaims ook evaluatievoorwaarden publiceren, en orthogonale analytische gegevens vrijgeven naast capaciteitsdecks, het volgen van zoiets als de voorgestelde orthogonale validatiesuite in plaats van een nauwkeurigheidscijfer. Kopers moeten om beide vragen voordat ze een ontwerpclaim als leverbaar product behandelen.
De visie is bescheiden maar nuttig: ‘AI-ontworpen’ wordt een statement over waar een reeks vandaan komt, en het releasepakket beslist of het bruikbaar is. De volgende stap is concreet. Vraag het analytische documentatie- en validatiepakket aan voor een kandidaat die u evalueert, en beoordeel de leverancier op wat dat pakket feitelijk laat zien over AI bij de ontdekking en ontwikkeling van peptiden.
Openbaring: MOL Changes is actief op de hier besproken peptide CDMO-markt, deze analyse heeft dus een commercieel belang. Niets in dit artikel is medisch of klinisch advies; raadpleeg een gekwalificeerde professional voordat u beslissingen neemt met biologische of klinische implicaties.