Hvorfor $300 Million Benchmark reframes AI i peptidopdagelse og -udvikling
GenScript i september 2026 aktieplacering sat nogenlunde $300 millioner bag et enkelt krav: at flaskehalsen i AI i peptidopdagelse og -udvikling sidder forrest i pipelinen, ikke bagsiden. Selskabet udstedte 77,126,000 nye aktier til HK$30,50 hver til mindst seks uafhængige investorer, rejste omkring HK$2,33 milliarder netto (vilkårene for placeringen, 2026-09-17). Den meget gentagne "$300 millioner" er en afrundet karakterisering af denne forhøjelse snarere end et tal fra selve ansøgningen.
Hvor pengene lander, betyder mere end overskriften. Opdelingen af finansieringsfordelingen dirigerer omkring HK$1,63 milliarder til AI-drevet lægemiddelopdagelsesplatformkapacitet og infrastruktur, omkring HK$470 millioner til R&D, digital workflow integration og global ekspansion, og omkring HK$230 millioner til generelle virksomhedsformål (2026-09-17). Det angivne automatiseringsmål er en "Gen-til-Protein" arbejdsgang, der løber fra AI-genereret sekvens til biologisk konstruktion til eksperimentel validering, bygget op omkring en "4-Day AI-to-Biology Validation Engine" og et mål, der ca 60% af den globale produktionskapacitet være AI-automationsdrevet ved udgangen af 2026. De Tamarind Bio bindebånd beskrives som at forbinde AI molekylært design med hurtig laboratorievalidering (2026-08-05).
En kildenote før analysen: tallene for placering og allokering spores til en enkelt opstrøms meddelelse om placering, der genrapporteres på tværs af finansielle forretninger, så de er én kilde, ikke fire uafhængige bekræftelser. Resten af denne artikel gennemgår overdragelsespunkterne, hvor en finansieret forudsigelse enten bliver analysekvalitetsmateriale eller ikke.
Nøgle takeaway: Kapitalen er rettet mod segmentet før eksperimentel validering, hvilket betyder, at benchmark for at bedømme ikke er modelydelse, men hvad der overlever syntese, oprensning og identitetsbekræftelse.
Det konventionelle syn: AI har allerede komprimeret peptidopdagelsestidslinjer
Mainstream-positionen er det generative design, multiparameter optimering, og højtydende computing har allerede kollapset design-til-kandidat-tidslinjen, og at leverandørplatforme nu leverer end-to-end opdagelse af AI-peptidlægemidler. GenScript oplyser, at dets "Gene-to-Protein"-arbejdsgang er ved at blive bygget til det formål, ved siden af det angivne automatiseringsmål det nogenlunde 60% af sin globale produktionskapacitet være AI-automatiseringsdrevet ved udgangen af 2026. Tamarind Bio-bindingen præsenteres som at forbinde AI-molekylært design med hurtig laboratorievalidering, og det fødererede læringsarrangement under Lilly TuneLab har medlemsbioteker, der bidrager med eksperimentelle resultater for at forbedre modeller, der forudsiger udviklingsevne og ADMET-egenskaber.
Udsigten er populær, fordi den er retningssand og kommercielt læselig. Et årti med ægte gevinster i strukturforudsigelse og ejendomsmodellering gav påstanden sit grundlag, og leverandører markedsfører nu hele kæden som ét produkt. Sælgerens egen platform sammenligning rapporterer en større end 95% syntesesuccesrate mod a 75% branchegennemsnit, med sekvenser op til 200 aminosyrer mod en angivet 4 til 50 aminosyre markedsgennemsnit. Disse tal er leverandørangivne, ikke uafhængigt verificeret.
Hvor den konventionelle udsigt går i stykker: Tre overdragelsespunkter
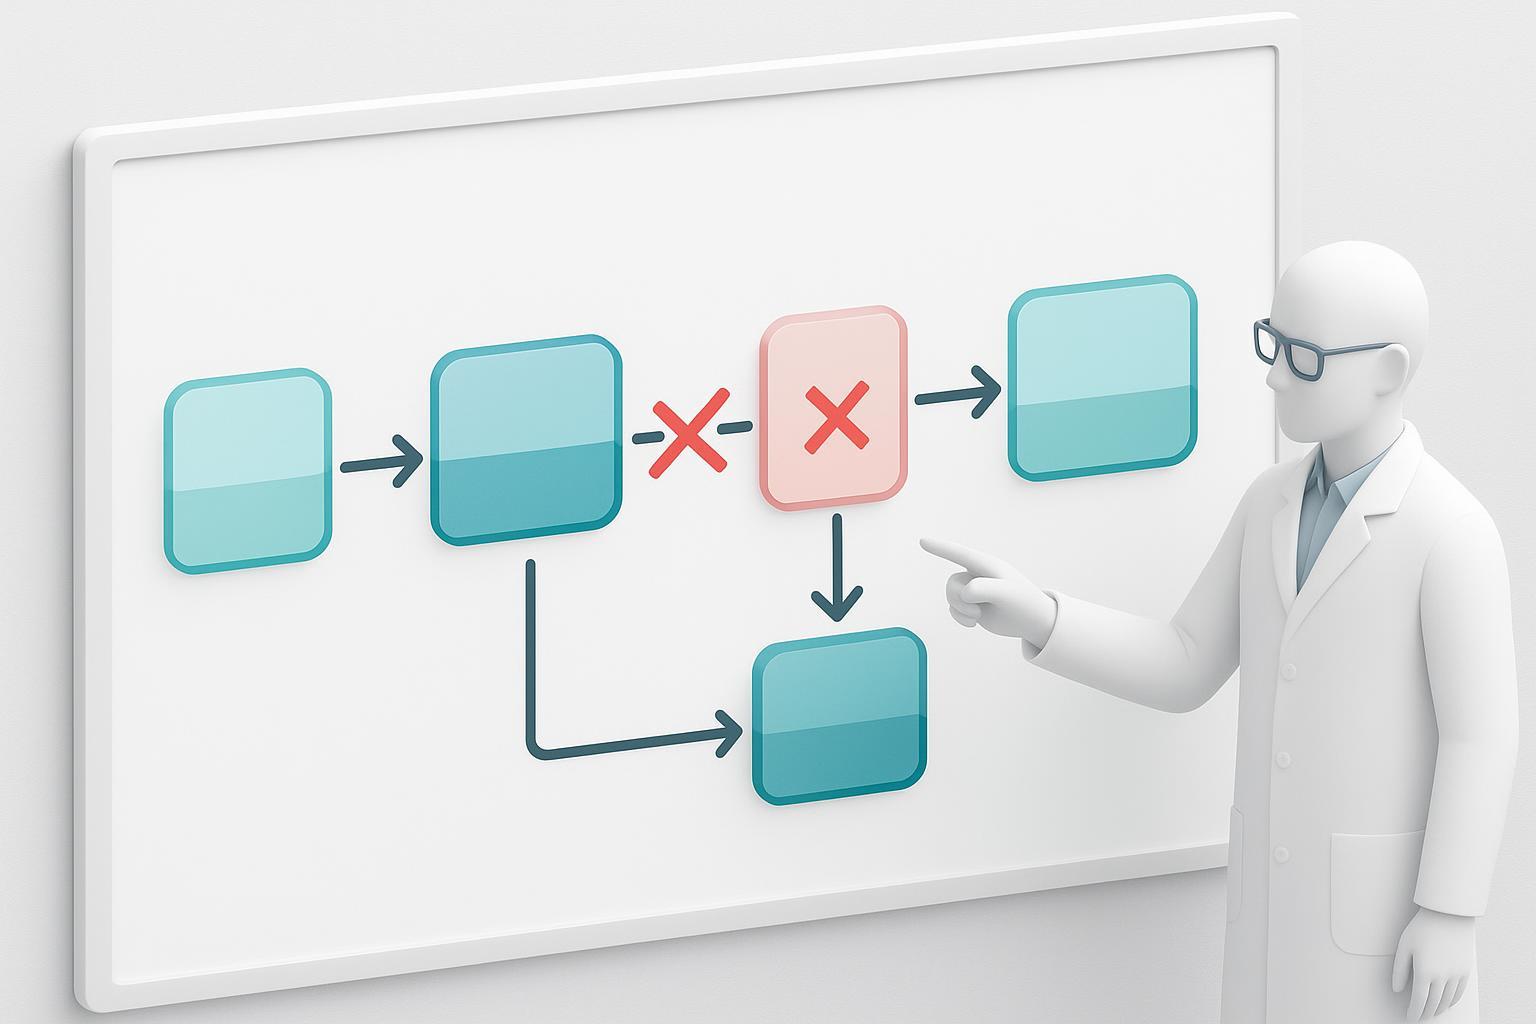
Rørledningen er ikke kontinuerlig, og dets diskontinuiteter er der, hvor kandidater dør. En modelscore, en syntesekørsel, og en analyseaflæsning er tre separate systemer med tre separate fejltilstande, og den konventionelle visning kollapser dem i én glat linje fra sekvens til resultat.
Den første pause er evalueringsprotokol inflation. Rapporterede målinger citeres ofte uden at skelne et tilfældigt opdelt testsæt fra et strukturelt uens, så et overskriftsnummer kan læses som valideret ydeevne, når det kun afspejler, hvor godt en model interpolerer inden for kendt sekvensrum. Den seneste gennemgang af datadrevet peptiddesign fremsætter denne kritik direkte: rapporterede diskriminationsresultater kan falde væsentligt, når først testsættet er opdelt efter stillads snarere end tilfældigt, som er den splittelse, der ligner en ægte ny kandidat.
Den anden pause er syntesegennemførlighed, som ikke er et modeloutput. Når AI-nominerede sekvenser når harpiksen, CDMO-overdragelses-tjeklisten navngiver de følgende fejltilstande: ufuldstændig Fmoc-afbeskyttelse, koblingsdæmpning og sterisk hindring fra aggregering på harpiks, N-1 og N-2 deletionssekvenser fra mislykkede koblinger, lav rå renhed, og lav restitution. Længde forstærker problemet. GenScripts egen vejledning siger, at peptider længere end 100 aminosyrer er "ekstremt svære at syntetisere" og håndteres fra sag til sag gennem fragmentering og ligering, om leverandørens egen syntesevejledning.
Den tredje pause er analyseartefakt. Sub-mikron kolloide aggregater kan adsorbere uspecifikt til plader og sensorchips, producerer kunstige nanomolære signaler, der forsvinder mod en monodispers kontrol.
Peptidsyntesekvalitetskontrol er, hvor disse brud overflader. Alle tre deler én grundlæggende årsag: den konventionelle opfattelse behandler en forudsigelse som et resultat.
⚠️ Advarsel: En modelrapporteret metrik er ikke valideret ydeevne, før den overlever en opdeling, der afspejler reel sekvensnyhed.
Hvad dataene faktisk viser om AI-designede peptider
De samme tal, der bliver citeret som bevis på AI-drevet designsucces understøtter en snævrere påstand: AI er et triage- og prioriteringslag, hvis output er en hypotese, ikke et resultat. Læs evalueringsbetingelserne og loftet bliver synligt.
Benchmark-rapporterne for udviklingsbarhed kun for sekvens 91.09% hæmolyse, 86.30% ikke-begroning, og 75.56% opløselighedsnøjagtighed under lighedskontrollerede spaltninger (benchmark for udviklingsbarhed kun for sekvens, 2023-11). PeptideBERTs rapporterede nøjagtigheder lander i et kompatibelt område på overlappende endepunkter, nogenlunde 86.05% hæmolyse, 88.37% ikke-begroning, og 70.02% opløselighed, som er delvis uafhængig bekræftelse snarere end et ekko (PeptidBERT fortryk, 2023-09). Opløselighed er det svageste endepunkt i begge.
CamSol-PTM-opløselighedsarbejdet viser, hvorfor det er vigtigt for screening af peptidudvikling: gennemsnitlig Pearson-korrelation af 0.72 på ikke-naturlige aminosyrepeptider, falder til 0.58 på GLP-1 varianter og 0.60 på generaliseringssættet, med to designs udelukket som ikke-producerbare (CamSol-PTM, Naturkommunikation, 2023-11). En model kan rangere opløselighed godt og stadig nominere sekvenser, der ikke kan laves.
En tre-gate-sekvens erstatter den enkelte konfidensscore: beregningsmæssig triage, derefter en syntese-gennemførlighedsskærm, derefter analytisk frigivelse. En kandidat går kun videre på eksperimentelt bevis ved hver gate, hvilket er hvad AI-designede peptidvalidering burde betyde i praksis.
Den bedre tilgang: Revider frigivelsesdataene, Ikke modelmålingerne
Evaluer AI-aktiverede peptidleverandører på deres analytiske udgivelsesdokumentation, ikke på den modelpræstation, de rapporterer. Princippet bag dette skift er enkelt: en forudsigelse er kun så god som det materiale, en leverandør kan give dig en sporbar analytisk registrering bag sig. Fire krav følger af overdragelsespunkterne ovenfor.
-
Spørg efter evalueringsbetingelsen bag hvert præstationskrav. En tilfældig opdeling og et strukturelt uens testsæt giver meget forskellige tal, og kun en af dem fortæller dig, hvordan modellen opfører sig på kemi, den ikke har set.
-
Kræv ortogonal identitetsbekræftelse, ikke et eneste massetjek. Den foreslåede ortogonale valideringssuite parrer RP-HPLC på C18 og C4 med ESI-MS eller MALDI-TOF, tilføjer cirkulær dikroisme på tværs af fjern-UV 190 til 260 nm, DLS eller SEC-MALS med et polydispersitetsindeks nedenfor 0.15, og et Ellmans assay for fri thiol under 0.05 mol SH/mol peptid. Disse er udgiver-foreslåede kriterier, ikke et mandat fra et standardorgan, så behandle dem som en startspecifikation at forhandle.
-
Kræv sporbarhed fra parti til parti og en erklæret konvention. Massebalancekonventionen det summerer målpeptid, peptidiske urenheder, modion og vand til 100% er det, der gør et renhedstal sammenligneligt mellem partier.
-
Peptidsyntese Kræv opskaleringsbevis fra mg til kg, ikke en enkeltskala demonstration. De offentliggjorte skalaintervaller beskriver leverandørspecifikationer snarere end uafhængige benchmarks, så spørg, hvilken skala udgivelsesdataene faktisk kom fra.
Til tip: Spørg efter split-protokollen, før du beder om præstationsnummeret. En leverandør, der kan beskrive testsættet, kan normalt også beskrive analysedataene.
Leverandører som MOL Changes udgiver analytisk udgivelsesdokumentation af denne art, hvilket gør revisionen til en dokumentanmodning snarere end et kapacitetsgæt. Det er her, kvalitetskontrol af peptidsyntese stopper med at være en markedsføringspåstand og bliver et sæt filer, du kan læse.
Sådan anvender du dette: En købers evalueringssekvens
Anmod om den analytiske frigivelsespakke, før du sætter dig igennem kapacitetsdækket. Den enkelte vending ændrer samtalen fra hvad en model kan forudsige til hvad en leverandør kan bevise, og det er den hurtigste måde at sortere leverandører, der har valideret materiale fra leverandører, der har valideret slides.
-
Spørg efter evalueringsprotokollen bag enhver rapporteret modelmetrik. Anmod om tog-/testopdelingsmetoden, den udholdte sætsammensætning, og om det rapporterede tal kommer fra retrospektiv scoring eller prospektiv syntese. Spørg samme dag, og svaret fortæller dig, om tallet er et benchmark eller et marketingaktiv.
-
Indsend en kendt-svær sekvens som en gennemførlighedssonde. En hydrofob eller aggregerings-tilbøjelig strækning afslører mere end et katalogpeptid nogensinde vil. Peptider overstået 100 aminosyrer håndteres fra sag til sag under leverandørens egen syntesevejledning, så vælg en sonde nær denne grænse i stedet for inden for det komfortable område. Dage til uger.
-
Revidere den analytiske pakke mod ortogonal bekræftelse, ikke et eneste LC-MS spor. Et massespektrum bekræfter massen, ikke rækkefølge. Spørg, hvordan leverandøren anvender den foreslåede ortogonale valideringspakke, og hvilke metoder der er rutinemæssige kontra citeret separat.
-
Anmod om lot-to-lot-data og massebalance-konventionen, der bruges til at rapportere nettopeptidindhold. Det er her, massebalancekonventionen har betydning: Syntetiske peptider renhed udtrykt mod peptidmasse og renhed udtrykt mod total tørvægt er forskellige krav, og kun én af dem overlever opskalering.
-
Bekræft opskaleringsbevis fra milligram til kilogram med renhed fastholdt ved specifikation. De offentliggjorte skalaintervaller viser, hvad en leverandør annoncerer; partihistorikken viser, hvad den gentager.
Trin
Artefakt anmodet
Hvad den fastslår
Typisk indsats
1
Evalueringsprotokol og splitmetodik
Om metrikken er prospektiv eller retrospektiv
Samme dag
2
Feasibility-sonde på en vanskelig sekvens
Om designkrav overlever syntese
Dage til uger
3
Ortogonal bekræftelsespakke
Sekvensidentitet ud over et enkelt spor
dage
Lot-to-lot data og massebalance-konvention
Om renhedskrav er sammenlignelige på tværs af partier
Uger
5
Opskaleringsbeviser, mg til kg
Om specifikationen holder, når batchstørrelsen vokser
Længere sigt
Spor om renhed og identitet gælder på tværs af partier, ikke om det første lod bestod. En leverandør uden en gennemførlighedssonde eller partihistorik diskvalificeres ikke, men det er ubekræftet, og den usikkerhed bør du prissætte i beslutningen.
Hvor dette argument er svagest
Den analytiske frigivelsesstandard, der foreslås her, er ikke et lovkrav, og en leverandør, der opfylder den, er dermed ikke en bedre videnskabelig partner. Det er en omhyggelighedsramme på købersiden, samlet ud fra offentliggjort praksis snarere end fra nogen bindende vejledning. Den ortogonale valideringspakke beskrevet i det foregående afsnit er foreslået af udgiver, og ingen regulator tvinger en sponsor til at køre det, før de citerer en designplatforms output.
Denne sondring betyder mest i det tidlige udforskningsarbejde. Hvis målet er at rangordne hypoteser for et forskerhold at triage, modelmålinger kan være helt tilstrækkelige, og at kræve en fuldstændig frigivelsesrevision på det tidspunkt er ude af proportion med, hvad arbejdet er til formål. Revisionen tjener sine omkostninger, når en forudsigelse er ved at blive analysekvalitetsmateriale.
Én ærlig begrænsning: evalueringsprotokol-kritikken hviler til dels på benchmark-tal, som ikke kunne genbekræftes i denne forskningsrunde. Hvis disse tal forringes mindre under strenge opdelinger end rapporteret, kritikken svækker, selvom de overdragelsespunkter, den beskriver, forbliver observerbare i publiceret syntese- og oprensningspraksis.
Standpunktet er, at forudsigelser bør revideres, ikke afskediget. Rækkefølge bevis er argumentet, ikke afvise beregningsmetoder.
Men skaber ikke hurtigere design stadig reel værdi?
Ja, og intet i dette argument bestrider det. At komprimere et søgerum og beslutte, hvilke sekvenser der er værd at lave, er rigtigt arbejde med reelle besparelser, og det er her AI i peptidopdagelse og -udvikling har fortjent sin plads.
Det tydeligste offentliggjorte eksempel er den AlphaFold-screenede aktiv læringsundersøgelse, som melder sig i bedring 50% af alle bindemidler, der bruger 15% af de forespørgsler, som en udtømmende stikprøve vil kræve, en forbedring på 3,3 gange i forhold til tilfældige stikprøver. Det er en væsentlig gevinst i forespørgselseffektiviteten, og det er værd at være præcis om, hvad det måler: hvor mange kandidater en model skal evaluere for at komme frem til en shortlist. Resultatet er et fortryk og er ikke blevet peer reviewed, så behandl størrelsen som foreløbig snarere end afgjort.
Uenigheden er snævrere, end den ser ud til. Forespørgselseffektivitet er en gevinst i designfasen. Den fortæller dig, hvilke sekvenser du skal bestille. Det siger intet om, hvorvidt de bindemidler, du genvinder, kan syntetiseres ved specifikation, renset til en acceptabel urenhedsprofil, eller bekræftet ved en ortogonal metode. En shortlist, der ikke kan rydde disse trin, er en hurtigere rute til et mislykket parti.
Hvad hvis vi allerede har investeret i en AI-designplatform?
Investeringen er ikke spildt, og overgangen er additiv snarere end en genstart. En designplatform bliver ved med at gøre, hvad den gør godt: rangliste kandidater, flagning af forpligtelser, og indsnævre et stort sekvensrum til en shortlist, der er værd at lave. Det, der ændrer sig, er, at organisationen tilføjer en gennemførligheds- og frigivelsesport nedstrøms, hvor hver shortlistet kandidat bedømmes på syntetiserbarhed, rensende adfærd, og ortogonal identitetsbekræftelse, før den opbruger assaykapacitet. De to lag er komplementære, ikke konkurrerer.
Den praktiske sekvensering er ligetil. Behold modellen. Tilføj sonden. Kræv derefter den fulde analytiske pakke på de første tre kandidater, før du skalerer forholdet til rutinearbejde. Det sidste trin er vigtigt, fordi det konverterer et leverandørforhold til et dokumenteret: du lærer, hvordan platformens forudsigelser opfører sig i forhold til dine egne udgivelseskriterier, på dine egne sekvenser, snarere end mod et benchmarksæt.
Hvor en overgangsmetrik ville hjælpe, Bemærk, at tal af denne type varierer fra kilde til kilde, så behandl ethvert enkelt tal med forsigtighed. Det fødererede læringsarrangement er en nyttig illustration af det underliggende princip: designoutput og eksperimentelle resultater forbedrer hinanden, når de er forbundet i en sløjfe i stedet for at blive holdt i separate systemer.
Hvordan reagerer du på leverandører, der citerer stærke publicerede benchmarks?
Brug benchmarkens metodologi i stedet for at bestride dets antal. En høj score under en tilfældig togtestopdeling og en lavere score under et stillads- eller enkeltledssplit er begge korrekte målinger af forskellige ting, og det nyttige spørgsmål er, hvilken måling leverandørens krav faktisk beskriver. Det er et spørgsmål om rækkevidde, ikke om ærlighed.
Den nylige gennemgang af datadrevet peptiddesign gør dette konkret: tilfældige opdelinger lader næsten duplikerede analoger sidde på begge sider af partitionen, så en model kan score godt ved at genkende nære slægtninge til sit træningssæt snarere end ved at generalisere til en ny kemisk serie. Stillads- og enkeltledssplitter fjerner den genvej og producerer lavere, mere ærlige tal.
CamSol-PTM-opløselighedsarbejdet viser den samme effekt på endepunktsniveauet. Dens rapporterede ydeevne er i gennemsnit omkring 0.72 på tværs af benchmark, men falder til nogenlunde 0.58 på GLP-1 varianter, et snævrere og hårdere omfang. Begge figurer er ægte. Heller ikke hele historien.
Til validering af AI-designede peptider, det praktiske skridt er at spørge hvilken split, hvilket endepunkt, og hvilket kemisk omfang producerede nummeret. Leverandører, der offentliggør deres splitmetodik, er nemmere at evaluere, ikke sværere, fordi kravet ankommer med sine grænser knyttet.
Det skifte, industrien har brug for
Benchmark GenScript's $300 millioner raise-sæt skal måles i analytisk frigivelsesevne, ikke modelmålinger. Det er det argument, som dette stykke har bygget hen imod, og det følger direkte af ledelsens egen indramning af forhøjelsen: kapitalen udvider delen før eksperimentel validering, mens syntese udføres, analytisk stringens, og steril fremstillingsevne forbliver uændret af det.
Det, der skal ændres, er en markedsnorm, ikke en eneste leverandørs praksis. AI-aktiverede peptidleverandører bør offentliggøre evalueringsbetingelser sammen med præstationskrav, og frigiv ortogonale analytiske data ved siden af kapacitetsdæk, efter noget i retning af den foreslåede ortogonale valideringssuite snarere end et tal for overskriftsnøjagtighed. Købere bør bede om begge dele, før de behandler et designkrav som en leverance.
Visionen er beskeden, men brugbar: "AI-designet" bliver et udsagn om, hvor en sekvens kom fra, og udgivelsespakken afgør, om den er brugbar. Næste skridt er konkret. Anmod om analytisk dokumentation og valideringspakke for en kandidat, du evaluerer, og bedømme leverandøren på, hvad den pakke faktisk viser om AI i peptidopdagelse og -udvikling.
Afsløring: MOL Changes opererer på det peptid-CDMO-marked, der diskuteres her, så denne analyse har en kommerciel interesse. Intet i denne artikel er medicinsk eller klinisk rådgivning; konsultere en kvalificeret professionel, før du træffer beslutninger med biologiske eller kliniske implikationer.