Брз одговор
GenScript's TuneLab deal covers proteins, не пептиди. Here's what AI-ready peptide discovery actually requires of your lab's records in 2026.
Што се случило и зошто е важно за откривање на пептиди подготвено за вештачка интелигенција
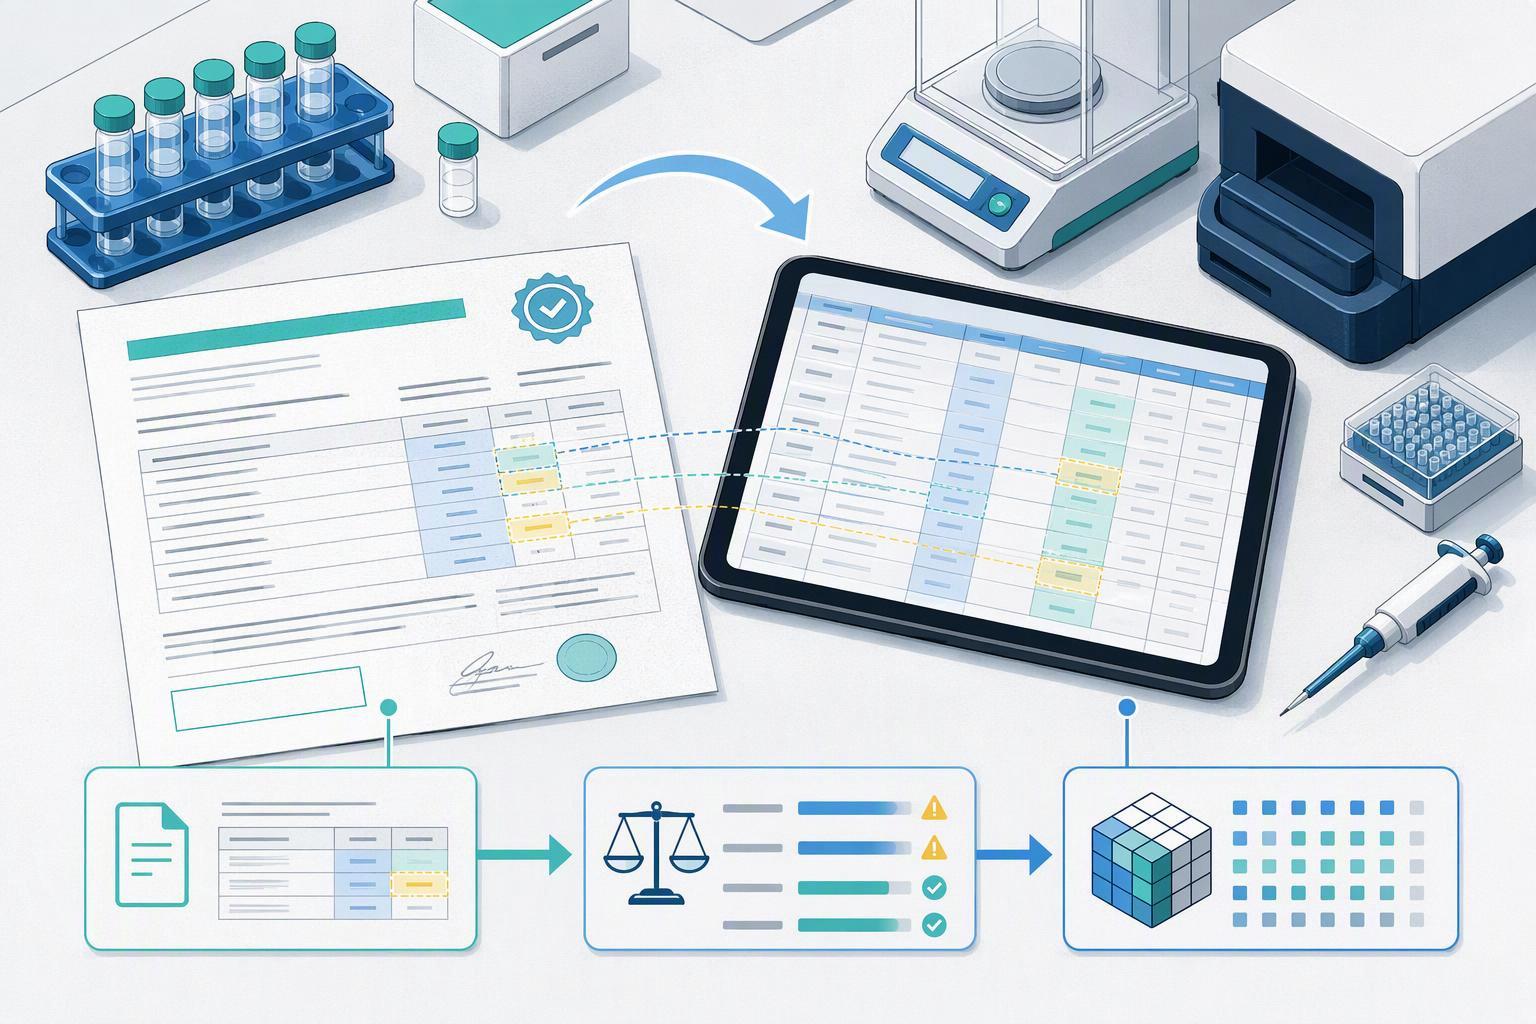
Вклучено 2026-09-16, Сопствената најава на GenScript за договорот TuneLab потврди дека компанијата сега нуди услови за влажна лабораторија со повластена стапка во објавата: изразување на протеини, прочистување и карактеризирање на приоритетните секвенци, врши под стандардизирани, целосно документирани протоколи. Внимателно прочитајте го опсегот. Нема стандард за податоци за пептиди, никаде во него не се именувани никаков машински читлив формат и никакви испораки специфични за пептиди.
Таа празнина е приказната. Реј Чен, Претседател на GenScript Life Science Group, го врами образложението во наведеното образложение на GenScript за партнерството: „Откривањето лекови со AI ќе напредува само толку брзо колку што индустријата може да генерира сигурни биолошки докази“.
Самиот TuneLab не е нов. Најава за лансирање на Lilly за TuneLab датира од 2025-09-09, управувана од Ели Лили наместо независна компанија, со првото ослободување кое ја покрива диспозицијата на лекот, безбедност и претклинички модели. Размерот зад него е причината поради која добавувачите обрнуваат внимание: комерцијални податоци добиени по цена од над $1 милијарди долари, извлечени од стотици илјади уникатни молекули, според скалата на податоците зад TuneLab. Пристапот се одвива преку дизајнот за федерално учење на TuneLab, што им овозможува на биотехнолошките работници да ги користат моделите на Лили без директно да ги изложат сопствените сопственички податоци или податоците на Лили.
Платформата е исто така вградена во софтверот што веќе го користат компјутерските тимови, преку интеграцијата на Schrödinger LiveDesign објави 2026-01-09 и ја објавија интеграцијата на TuneLab на CDD Vault 2026-05-20.
Затоа, третирајте го ова како сигнал за генерирање докази, не е спецификација. Ништо во соопштението не ви кажува што бара откривањето на пептиди подготвени за вештачка интелигенција од вашите записи. Тој товар паѓа на лабораторијата.
Чисти податоци: Четирите столбови на AI-Ready Peptide Discovery
Откривањето на пептиди подготвени за вештачка интелигенција значи дека вашиот експериментален излез може да се чита, споени и повторно употребени од модел без човечко да го препише. Машински читливите податоци ги носат своите единици, примерок за идентитет и верзија на методот во структурирани полиња наместо страница во PDF или тетратка. Циклусот дизајн-изградба-тест-учење е јамката на која работат тие модели: дизајн секвенци, ги синтетизираат и тестираат, врати ги резултатите, дизајн повторно.
Четири столбови ја држат таа јамка нагоре: почисти експериментални податоци, записи за репродуктивна синтеза, формати подготвени за анализа и аналитички сетови на податоци. Лентата е пониска отколку што претпоставуваат повеќето тимови. Упатство за собирање податоци на Cradle за дизајн на протеини го става дизајнот на генеративниот-ML протеин на дофат на која било лабораторија што може постојано да тестира наоколу 96 варијанти на протеинска секвенца за секое својство, и забележува дека неколку десетици мудро избрани секвенци можат да дадат значителен напредок. Објавено упатство за најдобра практика за инженерство на протеини со помош на ML известува дека збирките на податоци за ML за инженерство на протеини често чуваат помалку од 1,000 инстанци, поради што валидацијата најчесто користи 10-кратна вкрстена валидација наместо единечно задржување.
Малите збирки на податоци ги казнуваат невештите записи. Анализата на GEN за тоа зошто напорите за откривање на дрога со вештачка интелигенција не успеваат наведува дека моделите се хранат неконзистентни, нецелосни, двосмислените или лошо форматираните податоци го учат шумот заедно со сигналот, давајќи сигурни, но помалку веродостојни предвидувања. Моделот на неуспех е секојдневен: единици евидентирани како mg/mL во едно тестирање и µg/µL во следното, Имиња на примероци за слободен текст со кои ниту еден клуч за приклучување не може да се совпадне, недостасуваат идентификатори на серии, и нема верзии на методот на анализа или кодот за анализа. Секое од овие го спречува спојувањето на базата на податоци низ бегствата.
Причината нагоре е фрагментација, не невнимание. Преглед на LabKey за практично управување со податоците од анализата ги опишува податоците од анализата што живеат во силоси, на споделени дискови, во лабораториски тетратки, или вградени во е-пошта, со хетерогеност на инструментите меѓу продавачите и типовите на датотеки и без конзистентен формат. Според тоа, квалитетот на податоците на пептидите за моделите со вештачка интелигенција е проблем со записите пред да биде проблем со моделирањето.
Клуч за носење: Кампања која тестира наоколу 96 варијанти по имот е веќе во генеративно-дизајнерска територија. Она што ја дисквалификува базата на податоци се неконзистентни единици, Имиња на примероци со слободен текст, недостасуваат идентификатори на серии и неверзија методи, не бројката на примероци.
Репродуктивни записи за синтеза и формати подготвени за анализа
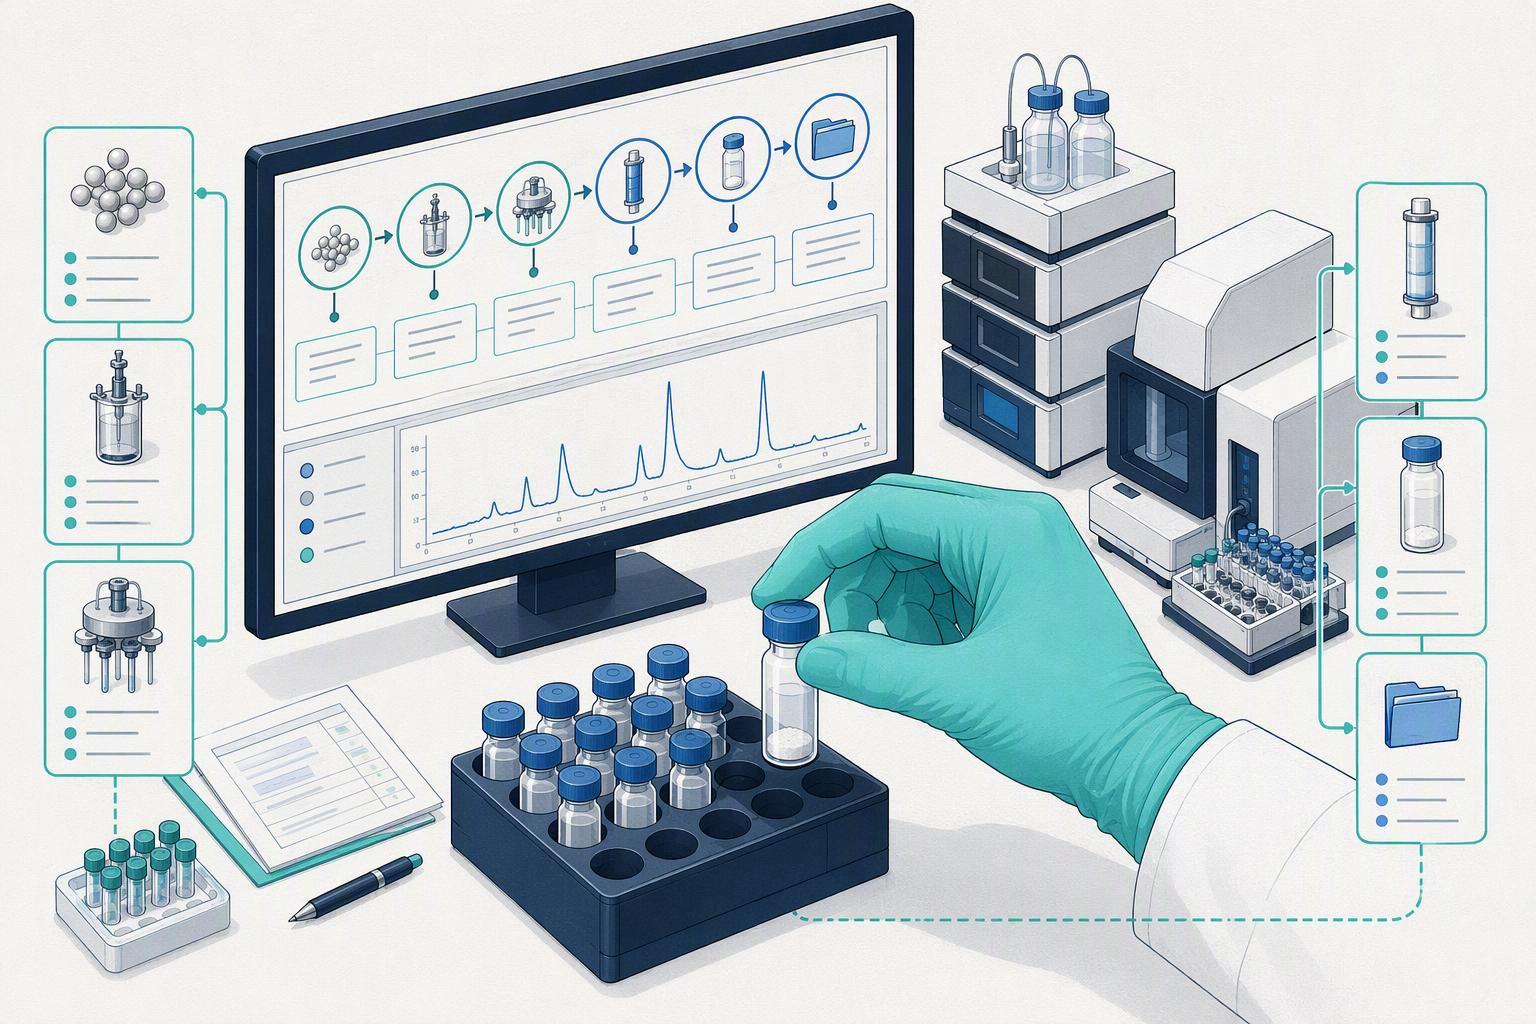
Сертификатот за анализа не е запис за синтеза на пептиди што може да се репродуцира. Единицата за репродуктивност е датотеката многу: на SPPS прајмер на Американското здружение за пептиди опишува сериски запис доволно детален за трета страна да го рекреира бегството, тип и полнење на смола за покривање, дезаштита по циклус и спојување со реагенси и еквиваленти, миење чекори и опрема. Стандардниот рачен циклус Fmoc што го документира го пропишува 20% пиперидин/ДМФ дезаштита (5 минути, тогаш 15 минути) и 3 × 1 mL DMF мие по циклус. Рамката на синџирот на старателство на MOL Changes фаза-по-фаза го проширува тоа во девет фази, од набавка на суровини и дојдовна квалификација преку записи за синтеза, следливост на означување на изотоп, аналитичко ослободување и комплетно склопување на датотеки со многу, цитирајќи го ICH Q7 за карактеризација на почетниот материјал и означување добавувач кој не може да го именува делот на смолата или изворот на аминокиселина.
Пептидните формати на податоци подготвени за анализа носат паралелно барање. Прегледот на LabKey за практичното управување со податоците од анализата идентификува што се повторува низ CSV, JSON, AnIML и SDRF: стабилни идентификатори за примероци, датотеки и работи; контролирани вокабулари или онтологии; експлицитни единици и типови на податоци; врски помеѓу необработени податоци, обработени податоци и метаподатоци; и отворени, долговечни формати. Потврдата на идентитетот со масена спектрометрија не е определување на чистотата со HPLC, и не ги решава прашањата за контрајон или содржина, како што е размената на контрајон TFA. I Q2(R2), објавено 30 ноември 2023, бара аналитичка постапка да се покаже соодветна за нејзината намена според однапред дефиниран протокол за валидација, со потврден опсег за известување дека ги вклучува горните и долните спецификации или ограничувања за известување, и ги проширува тие принципи на масена спектрометрија и други спектрометриски податоци.
|
Што содржи стандардниот пакет на добавувачи |
Што му треба на еден компјутерски тим |
|---|---|
|
CoA плус резиме аналитика |
Записи поврзани со многу со стабилни идентификатори |
|
Конечна чистота и идентитетски вредности |
Детали за синтеза по циклус и верзии |
|
Пептид 1 Статичен PDF или печатен извештај |
Циклична синтеза на пептиди Машински читливи табели со експлицитни единици |
|
Сертификат како испорака |
Потекло од суровини Пептидни услуги материјал за ослободување |
Ниту еден стандард за документација не ја отстранува потребата Пептид 2 за ортогонална потврда на ударите.
Што значи ова за добавувачите, Компјутерски тимови и купувачи
Огласот се појавува поинаку во зависност од тоа каде седите. За добавувачот за синтетизирање, комплетноста на документацијата станува диференцијатор наместо последователна мисла. Страна за услуга за AIDD на GenScript рекламира редослед-до-податоци во најбрзо време 4 календарски денови, 4000+ дизајни на ден, 20Точки на податоци подготвени за М+ AI генерирани годишно, под $10 по податочна точка, и 3500+ глобални партнерски организации. Прочитајте го внимателно, иако, и воопшто не именува пептиди; неговите наведени модалитети се VHHs, минипротеини, IgG, биспецифики, ензими и de novo протеини. Пептидната хемија сè уште не е покажаниот центар на тој гасовод, што е отвор за добавувачите кои можат да го покажат. Синтеза на калцитонин
За компјутерскиот тим, обврзувачкото ограничување е големината на базата на податоци и доволноста на метаподатоци. Објавено упатство за најдобра практика за инженерство на протеини со помош на ML го третира 10-кратното вкрстено валидирање како норма за под 1.000 примероци на податоци, што ви кажува колку обично е тенок материјалот за обука. Дизајнот за федерално учење на TuneLab е важен овде: биотехнолошките технологии ги користат моделите на Лили без директно изложување на сопственички податоци. Неочигледната импликација е дека интеграцијата на Schrödinger LiveDesign значи дека повеќето тимови ќе ги исполнат овие модели во софтверот што веќе го работат. Моделите не се променливата што ја контролирате. Податоците што ги давате се.
За купувачот или КК олово, „Документирано“ веќе има дефиниција. Десетте принципи за интегритет на податоци ALCOA+ бараат записите да се припишуваат, читлив, истовремена, оригинален, точни, комплетен, конзистентна, трајни и достапни, и ICH Q2(R2) упатството за аналитичка валидација бара аналитичката постапка да се покаже соодветна за нејзината намена според однапред дефиниран протокол за валидација, со ревизијата што ги прошири тие принципи на масена спектрометрија. Документација-целосна испорака на пептиди, во тие услови, значи многу датотека каде идентификаторот на примерокот се врзува за серијата, верзијата на анализата и единиците патуваат со резултатот, а контролите и метриката за грешки се наведени наместо да се подразбираат. MOL Changes е еден добавувач чиј аналитички пакет е изграден околу тој синџир, иако не беше пронајдена независна ревизија на нејзините формати на податоци специфични за вештачката интелигенција.
Четири прашања што треба да ги поставите на вашите сопствени записи денес: Може ли модел да ја прочита оваа табела? Дали трета страна може повторно да ја создаде оваа серија? Дали овој излез од анализата носи идентификатори и единици? Дали оваа база на податоци може да се спои со податоците од минатиот квартал? Пептид 3
Што да направите сега и поголема слика
Започнете со извозот, не платформата. Три акции, по редослед на итност.
-
Оваа недела: проверете го извозот на анализа на една неодамнешна кампања според вашата машински читлива листа на полиња и запишете што недостасува. Повеќето тимови ги наоѓаат празнините во попладневните часови.
-
Овој месец: додадете идентификатори на серии, единици, верзија на анализа и верзија на код за анализа во шаблонот за извоз, и започнете со верзија на самиот метод на анализа.
-
Овој квартал: побарајте ја целосната датотека со многу, вклучувајќи многу смола и извор на аминокиселини, пред да се посветат на кампања. Добавувачот кој не може да ја именува групата смола или изворот на аминокиселини е црвено знаме.
Две работи што не треба да се прават. Не ја обновувајте платформата за податоци пред да го поправите форматот за извоз, и не третирајте CoA како база на податоци подготвена за обука.
Вреди да се има предвид предупредувачкиот контекст. Во рачна ревизија за повторна употреба FAIR на архивирани збирки на податоци, 45.9% од оценетите отворени збирки на податоци беа оценети за повеќекратна употреба, значење 54.1% не беа. Во ревизијата на податоци од енергетскиот домен, 82% на збирките на податоци недостасуваа податоци во најмалку една клучна димензија и 27% недостасуваа повеќе од половина. Бројките од овој тип варираат според изворот и доменот, и тие се наведени овде како илустрација за стапките на загуба на метаподатоци, не како пептидни репери.
Тоа е поголемата слика за откривање на пептиди подготвени за вештачка интелигенција: генерирање докази, не модел способност, станува чекор за ограничување на стапката. Стандардите за документација се претвораат во критериум за набавка, а лабораториите што сега ќе ги верзираат нивните записи ќе бидат оние чии податоци сè уште ќе бидат употребливи за три години.
Следен чекор: прегледајте ја рамката за документација за синџирот на притвор и користете ја нејзината листа за проверка од девет фази за да ги постигнете вашите тековни датотеки со многу.
Откривање: MOL Changes го објавува овој блог како продавач на пептиди.
Најчесто поставувани прашања
Дали партнерството GenScript–TuneLab опфаќа пептиди?
бр. Сопствената најава на GenScript за договорот TuneLab ја опфаќа услугата за изразување на протеини, прочистување и карактеризирање на приоритетните секвенци. Синтезата на пептиди не е именувана во тој опсег, така што пептидните тимови треба да ја читаат објавата како сигнал за тоа каде се движи откритието со помош на вештачка интелигенција, а не како услуга што можат да ја купат денес.
Што всушност значат во пракса податоците „подготвени за вештачка интелигенција“.?
Тоа значи пет конкретни својства: стабилни идентификатори за секој ентитет, контролирани вокабулари наместо полиња со слободен текст, експлицитни единици и типови на податоци, поврзани суровини, обработени и метаподатоци датотеки, и отворете долготрајни формати наместо извоз заклучени од продавачите. Прегледот на LabKey за практично управување со податоците од анализата ги поставува овие барања за податоците од анализата. Датотеката што ги задоволува може да се анализира со модел без прво заглавија на колони за препишување луѓе. Тоа е целиот тест.
Колку голема треба да биде аналитичката база на податоци за пептиди пред да помогне машинското учење?
Помал отколку што претпоставуваат повеќето тимови, но не тривијално мали. Упатството на Cradle за собирање податоци за дизајн на протеини го става генеративниот дизајн практично од околу 96 варијанти по имот. Типични збирки на податоци за протеинско инженерство, за разлика од тоа, држете помалку од 1,000 инстанци и се потврдени со 10-кратна вкрстена валидација, како што опишува објавеното упатство за најдобра практика за инженерството на протеини со помош на ML. Обврзувачкото ограничување е обично конзистентност во тие случаи, не нивната бројка.
Што да побарам од добавувач?
Побарајте ја целосната датотека со многу, не само CoA. Рамката за синџир на притвор фаза-по-фаза на MOL Changes го третира добавувачот кој не може да ја именува количината на смола или изворот на аминокиселина како црвено знаме, и бара машински читливи аналитички податоци заедно со сертификатот. Ако форматите на податоци за пептиди подготвени за анализа што ги добивате не може да се вчитаат без рачна транскрипција, нафтоводот за откривање на пептиди подготвен за вештачка интелигенција застанува во вашето сандаче.
Заклучок
Партнерството GenScript-TuneLab е сигнал за тоа како се генерираат докази за пептиди, не е стандард за податоци за пептиди. После тоа, нема објавени податоци за независни тестови 2024 беше пронајдено што би дозволило секој да го третира огласот како решена спецификација, така што практичната работа останува таму каде што отсекогаш била: во записот што вашата лабораторија веќе го произведува.
Тој запис има четири барања според кои можете да дејствувате сега. Чистите податоци значи полиња што моделот може да ги анализира без рачна поправка. Репродуктивните записи за синтеза на пептиди значат следливост на ниво на многу назад до изворите на смола и амино киселини. Форматите на податоци за пептиди подготвени за анализа значат резултати што го преживуваат преносот помеѓу инструментите и соработниците. Пептидните аналитички бази на податоци за пресметковен дизајн значат дека основните мерења остануваат прикачени на секвенците што ги опишуваат.
Следниот логичен чекор е мал и негламурозен: земете една завршена кампања, извезете го како што е денес, и проверете го поле по поле со машински читлива спецификација. Што и да не успее таа ревизија е вашиот патоказ за откривање на пептиди подготвен за вештачка интелигенција, и ќе биде поконкретно од било кое соопштение.