Што всушност бараат работните текови на податоци за пептиди за откривање лекови со вештачка интелигенција
Работните текови на податоци за пептиди за откривање лекови со вештачка интелигенција се водат за евиденција, аналитички, и практики на владеење кои прават машински употребливи податоци за пептиди преку предвидувачки модел. Тие покриваат пет области: записи за секвенца и модификација, контекст на анализа, податоци за нечистотија, историја на серија, и стандардизирани аналитички резултати. Она што ги одделува од генеричкиот совет за подготвеност за податоци е дека секое барање се спушта на ниво на поле за индивидуална евиденција, и секој од нив треба да преживее и преглед на доверливост и документиран протокол за валидација.
Лентата за рекордно ниво е делот што повеќето тимови го потценуваат. Референтниот третман на нотацијата на структурата на пептидот смета дека цевководите за машинско учење најдобро функционираат од хемиски приказ без загуби како примарен запис, со кодирање специфични за моделот кои произлегуваат од него наместо складирани како извор на вистината (Прибелешка на структурите на пептид со употреба на НАСМЕВКИ и други хемиски кодови, 2017). Во тој пристап, InChIKey делува како клуч за идентитет и дедупликација, додека цикализацијата и вкрстените врски мора да бидат напишани како експлицитни објекти за поврзување наместо да останат имплицитни.
Регулаторите се движат во иста насока. Јануари на ФДА 2025 нацрт-упатството за вештачката интелигенција во регулаторното одлучување воведува проценка на кредибилитет базирана на ризик, поврзана со дефиниран контекст на употреба (Нацрт насоки на FDA, актуелна содржина 2025-01-06). Тоа е нацрт, не за имплементација, но сигнализира дека збирките на податоци за пептиди подготвени за вештачка интелигенција ќе се оценуваат според следливоста наместо волуменот.
Клуч за носење: Три работи ги разликуваат овие работни текови од обичното чистење на податоците: барања за евиденција на ниво на терен, механика за доверливост што им дозволува на партнерите да споделуваат без да се изложуваат на олово, и оперативен протокол за валидација наместо наведен принцип.
Две заблуди предизвикуваат најголем дел од конфузијата. „Чисти податоци“ не значи „курирани податоци“, уредна табела сè уште може да биде неупотреблива за модел. И еден број за чистота не опишува пептид; податоците за нечистотијата и историјата на серијата ги носат информациите од кои моделот всушност може да научи. Овој дел се базира на рецензирана литература за структура и нотација и тековните регулаторни упатства, без извори на продавачи.
Зошто Работните текови на податоци за пептиди за откривање лекови со вештачка интелигенција се важни сега
Работните текови на податоци за пептиди за откривање лекови со вештачка интелигенција се важни бидејќи парите сега се движат пред податоците. Во 2026 Следач на зделки со вештачка интелигенција објавен од VLS Research, Објавените авантури се групираат на 30-50 милиони долари наспроти насловните вредности над 1 милијарда долари, приближно 2–3% од насловната вредност платена во готовина (VLS истражување, Следење на зделки за откривање на дрога со вештачка интелигенција 2026, извадено 2026-07-03). Isomorphic Labs-Eli Lilly покажува околу 45 милиони долари однапред наспроти над 1,7 милијарди долари во пресвртници; Noetik-GSK однапред покажува 50 милиони долари на петгодишна структура за лиценцирање. Забележете го изворот: еден аналитичар тракер, со интерес на продавач за наративот за зделка со вештачка интелигенција.
Клиничката евиденција е противтежа. Околу 90% молекулите кои влегуваат во клиниката никогаш не добиваат одобрение, и 50-60% од неуспесите во Фаза II произлегуваат од недостаток на ефикасност, бројки кои едвај се поместуваа во две децении (Мао З & Јан Л, Граници во фармакологијата, извадено 2026-07-03). Истото 2024 систематски преглед на 20 Програми управувани од вештачка интелигенција од 2018 до 2023 Откриено е дека оптимизацијата на олово со помош на вештачка интелигенција го намалува времето на проверка на кандидатот за 30-50% во просек, додека трошењето на фаза I/II остана споредливо со индустриските одредници.
Таа празнина е поентата. Партнерите сега можат да потпишат модел, но моделот не може да учи од записите кои никогаш не го фатиле пептидот.
Ова влијае на Р&Д води, аналитичка хемија, податоци и ИТ, и менаџерите на сојузот кои наследуваат прашања за ажурност по потпишувањето.
Петте столбови на податоци на AI-Ready Peptide Datasets
Збирките на податоци за пептиди подготвени за вештачка интелигенција се изградени од пет столбови на рекордно ниво, и заедно ја формираат контролната листа за подготвеност против која тимот може да постигне гол пред да потпише договор за партнерство. Each pillar below is written the same way: why it matters, како да се спроведе, and what failure looks like when it is missing. Нарачката е намерна. Identity comes first because every downstream field, from assay context to impurity profile, inherits the errors of an ambiguous structure record. A model trained on a mis-specified sequence does not fail loudly; it learns the wrong molecule and reports confident predictions about it.
Score each pillar honestly. A team that can reconstruct every peptide from its own records, attach assay conditions to every result, and trace every lot to a certificate of analysis is ready to hand data to a partner. A team that cannot is not blocked from partnering, but it should expect the first months of the collaboration to be spent on data remediation rather than model training.
Апчиња 1: Недвосмислени записи за низа и модификација
Пептидната секвенца и модификацијата ја запишуваат материја бидејќи моделот не може да научи од пептид што не може да го реконструира, и грешките на идентитетот тивко се шират низ секое надолно предвидување. Поправката е хемиска претстава без загуби како примарен запис, со кодирање специфични за моделот кои произлегуваат од него наместо складирани како извор на вистината.
Имплементацијата следи мал сет на конвенции. HELM се справува со структури кои се свесни за полимер, вклучувајќи гранки и неприродни мономери, додека SMILES служи графички модели на атомско ниво. InChI и InChIKey делуваат како копчиња за дедупликација и идентитет низ системите. Циклизацијата и вкрстените врски припаѓаат во експлицитни објекти за поврзување, никогаш како имплицитна претпоставка дека „циклизирана“ секаде значи исто. Референтниот третман на нотацијата на структурата на пептидот го опфаќа останатото: шифри со повеќе букви за непротеински или неприродни остатоци, прибелешка со мали букви за D-амино киселини, и прибелешка за модификација на ниво на остаток во формат MAP (Весник за хемиформатика / PMC).
Режимот на неуспех е тивок и скап. Програма снима лактамски мост и дисулфид како „циклизирани“ во истото поле, така што моделот третира две хемиски различни скелиња како едно. Секое предвидување изградено на таа колона е контаминирано, и ништо во нафтоводот не го означува.
Записот што може да се користи за модел за модифициран макроцикличен пептид го носи полето поставено подолу. MOL Changes го поддржува овој пристап како прв структура во неговата работа со податоци за пептиди, и примерот може да се реплицира со кој било усогласен систем за евиденција.
|
Поле |
Запис што може да се користи за модел |
Типичен запис со слободен текст |
|---|---|---|
|
Примарна застапеност |
Низа HELM со експлицитни објекти за поврзување |
Секвенца залепена во поле за белешки |
|
Кодирање на ниво на атом |
НАСМЕВКИ произлезени од рекордот на HELM |
Отсутен |
|
Синтеза на пептиди Клуч за идентитет |
InChIKey за дедупликација |
Отсутен |
|
Неприродно Синтетички пептиди остатоци |
Кодови со повеќе букви, дефинирани во мономерна табела |
Приближувања со една буква |
|
Стереохемија |
Прибелешка со мали букви D-амино киселина |
Не е снимен |
|
Модификации |
Прибелешка MAP на ниво на остатоци |
Белешка со слободен текст, на пр. „циклизирана“ |
|
Тип на циклизација |
Експлицитен мост објект со позиции |
Двосмислена |
|
Услуги Вкрстени врски |
Експлицитен објект за поврзување |
Отсутен или имплициран |
Апчиња 2: Контекст на анализа што патува со резултатот
Врзувачкиот афинитет без неговите услови за анализа не е ознака за обука, тоа е бројка. Контекстот на анализата мора да патува со резултатот: тип на анализа, целната конструкција и видот, формат за читање, и дали вредноста била измерена или предвидена.
Разликата измерено наспроти предвидено е местото каде што повеќето збирки на податоци тивко се прекинуваат. А 2025 систематски преглед на предикторите за епитоп откри дека само 174 на 777 (22%) пресметано предвидените HLA-врзувачки пептиди во една студија SARS-CoV-2 беа потврдени дека стабилно се врзуваат in vitro (npj вакцини, 2025-08-30). Таа бројка е опфатена на една студија, не е општа стапка на точност за АИ во имунологијата, но покажува зошто предвидената вредност и измерената вредност не можат да споделат колона без знаменце што ги одвојува.
⚠️ Предупредување: Здружување SPR, флуоресцентна поларизација и вредности базирани на клетки во една колона на афинитет го обучуваат моделот на анализата, а не на хемијата. Моделот дознава која лабораторија го генерирала бројот, не кој пептид се врзува.
Апчиња 3: Impurity Profiles, Ниту еден број за чистота
Податоците за нечистотијата на пептидите и историјата на сериите припаѓаат во записот како профил, не е процент од насловот. Пријавени два лота на 98% чиста може да се однесува поинаку во анализата, и на моделот му треба обвивката на нечистотија и состојбата на контрајон за да се види зошто.
Ефектите на контрацепција се добро документирани. Во а 2025 преглед, пептидот M33 како TFA сол покажа 5-30% поголема цитотоксичност кон нормалните бронхијални епителни клетки од ацетатниот пандан, и MOG пептидот формулиран со TFA беше поврзан со почетокот на енцефаломиелитис приближно 5 дена порано со споредлива инциденца и сериозност (Биомолекули, 2025-11-07). Посебен преглед покажа дека хлоридот е најмалку ефикасен од тестираните анјони за поттикнување на спирална структура во LL-37 (Фармацевтски производи / Молекули, 2020-12-03). Ова се набљудувања зависни од формулацијата, не е сеопфатна изјава дека секој контрајон е небезбеден.
Имплементацијата значи складирање на времињата на задржување на нечистотијата, релативните области и состојбата на размена на контрајони заедно со бројката за чистота. За нивоата за валидација, I Q2(R2) го поставува опсегот на валидација наместо границите на чистотата на пептидите: тестирањето за нечистотија мора да го покрие прагот на известување до 120% на ограничувањето на спецификацијата, а чистотата по површина проценти е потврдена од 80% на долниот до 100% од горната граница на спецификација (I Q2(R2), конечното упатство 2023-11-30).
Апчиња 4: Историја на серија и сертификати за анализа поврзани со многу
Довербата на моделот е својство на следливост, поради што многу броеви, Поврзаноста на сертификатот за анализа и историјата на повторно тестирање припаѓаат во датата на податоци, а не само во системот за управување со квалитет. Очекувањата ALCOA+ што сега треба да ги задоволат цевководите за AI/ML се веќе постоечки GMP стандард, проширен на нов случај на употреба, не е ново правило измислено за модели. Низата на податоци е означена како критична грижа бидејќи AI/ML се интегрира со MES и LIMS, а дигиталната нишка е дефинирана како непрекинат синџир на врски со податоци од тестирање на суровините преку производство до објавување на финалниот производ (Регулаторни перспективи за имплементација на AI/ML, PMC, 2025-06-16).
За Совет: Задржете ја историјата на повторно тестирање и повторна анализа наместо препишување Купувајте тоа. Заменета вредност со временски печат е доказ; заменетата вредност е празнина.
Режимот на неуспех е кампања со двојно броење. Три анализи кои се извршуваат на иста лота се внесуваат како три независни набљудувања, а моделот третира една серија како три, зголемување на довербата во резултат кој никогаш не бил повторен.
Апчиња 5: Стандардизирани аналитички резултати и машински читливи формати
Стандардизираните аналитички резултати за пептидната вештачка интелигенција зависат од форматите што може да ги анализира гасоводот без рачно чистење. Машински читливи стандарди веќе постојат за аналитичкиот слој: mzML за необработени податоци за масена спектрометрија, mzIdentML и mzTab за идентификации и квантификација, PX-XML за метаподатоци за поднесување, SDRF-Proteomics за примерок и односи со изложеност, и USI за идентификатори на стабилен спектар (Инфраструктура на податоци на Proteomics).
Репродуктивноста бара и целосен блок метод. Параметрите на методот на HPLC ја вклучуваат хемијата на колоните (typically C18), particle and pore size, column dimensions, мобилни фази и модификатори, градиент програма, брзина на проток (наоколу 1.0 mL/min analytical), температура на колоната, откривање бранова должина (типично 214-220 nm за пептиди) and injection amount. Идентитетот мора да биде потврден со LC-MS или MALDI-TOF со недопрена маса со набљудувана наспроти теоретска маса и наведен прозорец за прифаќање ppm или Da, not by HPLC alone (Phenomenex HPLC центар за знаење, 2026-07-29).
Режимот на неуспех е запис кој вели „стандарден RP-HPLC градиент“. Without the method block, резултатот не може да послужи како сидро за валидација, а партнерот не може да го репродуцира.
Confidentiality: Споделување податоци за пептиди без истекување на олово
Ризикот за доверливост во партнерствата со ВИ пептиди е мерлив, not theoretical. А 2025 студија на невронски мрежи за откривање лекови откри дека во сценарио на црна кутија каде што се изложени само излезни логити, како што е модел кој се нуди како веб сервис, Нападите за заклучок за членство идентификуваа кои хемиски структури биле во комплетот за обука, а комбинирањето на неколку напади го зголеми ризикот (Објавувањето на невронски мрежи во откривањето лекови може да ја загрози доверливоста, 2025-03-26). Авторите забележуваат дека молекулите од малцинските класи, често највредните во откривањето на лекови, се особено ранливи, и дека уникатни структури кои се разликуваат од воспоставените библиотечни соединенија може да одговараат на сопственички води или нови скелиња во развој.
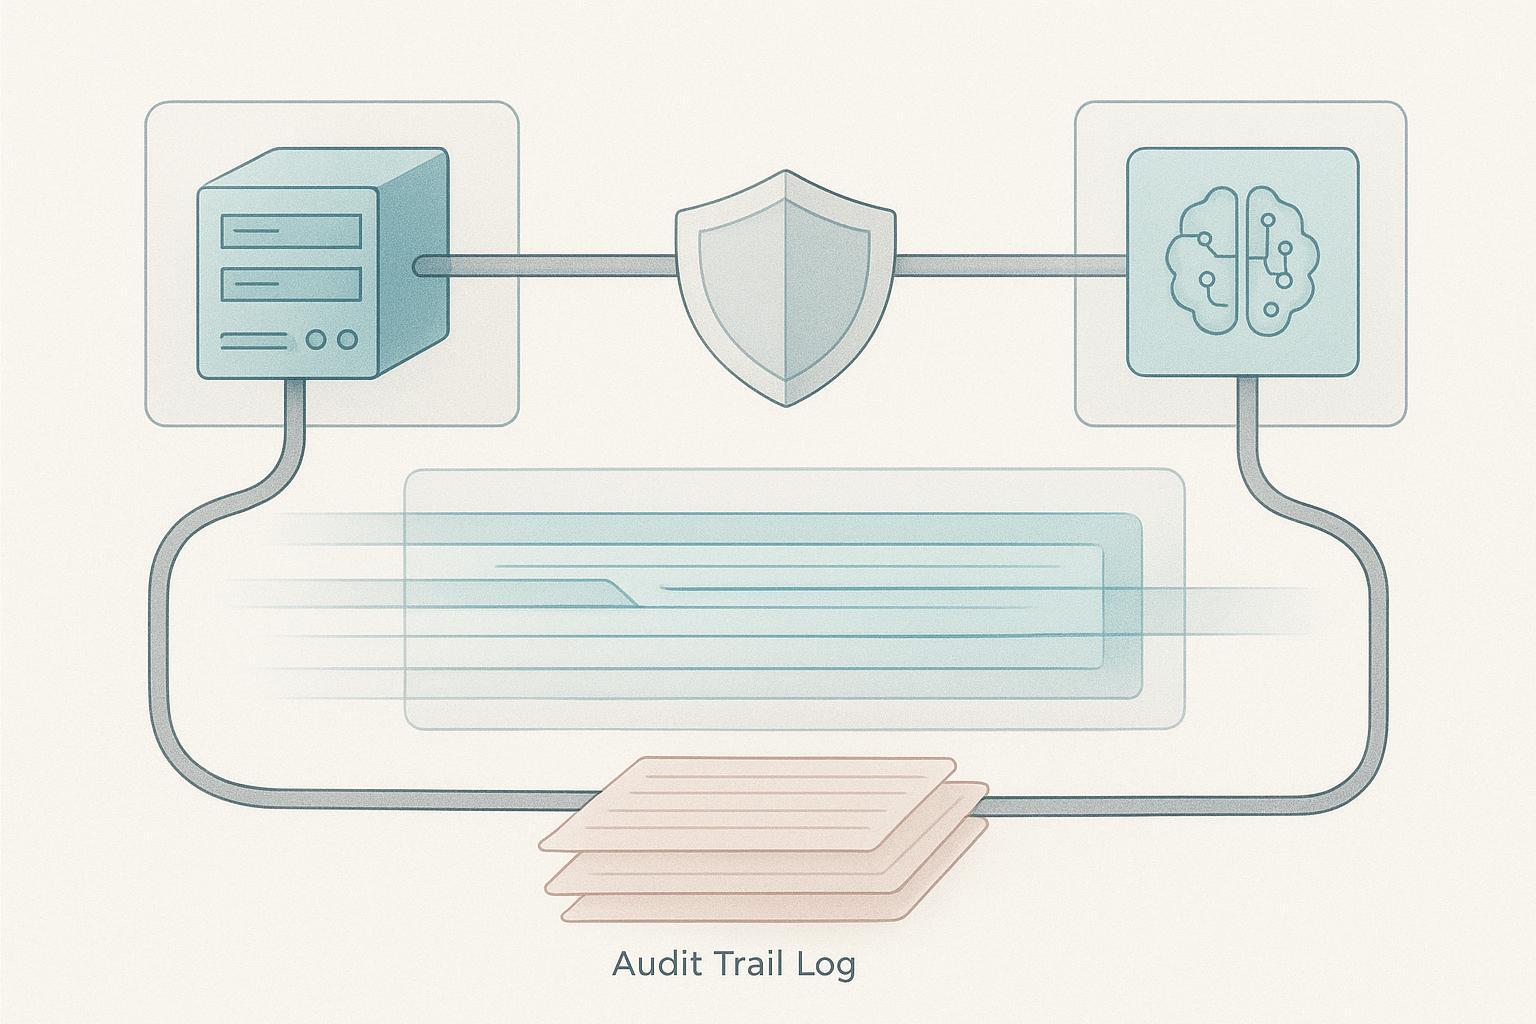
Оперативниот одговор е модел за пристап со нивоа, а не единствена одлука за споделување податоци. Спонзорите чуваат необработени записи во куќата; партнерот добива деидентификувани или хаширани претстави каде што задачата за моделирање дозволува; само збирните резултати ја напуштаат соработката. Договорни ограничувања на она што партнерот може да го задржи, плус ревизорска трага на секое барање во однос на споделениот сет, затворете ја јамката.
Клуч за носење: Деидентификацијата го намалува ризикот од истекување, но не го елиминира за структурно карактеристични пептиди, така што ревизијата на нивоа и барање ја носат тежината што само маскирањето не може.
Scientific Validation: An Operational Protocol, Not a Principle
Потврдувањето не е принцип со кој се согласувате. Тоа е низа што ја извршувате: прво ортогонална потврда, потоа независна репликација, потоа усогласување на секоја вредност со која се соочува моделот назад со необработените аналитички податоци од кои доаѓа. Прескокнувањето на третиот чекор е најчестиот неуспех, затоа што усогласен број и неусогласен број изгледаат идентични во табелата за обука.
Дефинирајте го ортогоналниот пар по тип на приговор пред да генерирате нешто. За идентитетот, спарете ја недопрената маса со секунда, механички различен метод наместо повторување на инјектирање на истиот инструмент. За активност, спари отчитување на биофизичко врзување со функционално отчитување базирано на клетки, бидејќи двајцата одговараат на различни прашања.
Репликацијата мора да користи независно синтетизирана група, не е повторно прикажување на истиот материјал. Извршувањето на истата анализа двапати на иста група ја мери прецизноста на инструментот, не генерализација. А 2025 систематскиот преглед на методите за предвидување на епитопот покажа дека многу тековни пристапи страдаат од прекумерно прилагодување на нивните збирки податоци за обука, што драстично го ограничува колку добро тие се префрлаат на нови цели (npj вакцини, 2025-08-30). Истиот преглед забележува дека не сите врзива се имуногени: највисоко рангираниот епитоп може да ги врзува антителата in vitro, но сепак да не успее да го изведе предвидениот одговор in vivo, и точноста на репер не се пренесува кога читањето, клеточна линија, или целниот контекст се разликува.
Тоа е режимот на неуспех да се дизајнира против. Комплет за валидација извлечен од истата кампања како и комплетот за обука го мери меморирањето, не генерализација.
The Benchmark Gap: Што стандардизацијата сè уште не може да се поправи
Стандардизацијата е неопходна, но не и доволна. Реперите на теренот се нови и тесни, и ниедна табла сè уште не може да го измери она што тврди дека го мери.
PepBenchmark, стандардизираниот пептид-ML репер објавен во април 2026 и презентиран на ICLR 2026, корици 29 канонско-пептид плус 6 не-канонски-пептидни сетови на податоци низ 7 групи, со унифициран цевковод за претпроцесирање и табла на водачи што опфаќа четири фамилии на методи: Отпечаток од прст, GNN, PLM, и НАСМЕВКИ. Нејзините автори јасно наведуваат дека претходната работа била „попречена од отсуството на стандардизирани одредници“ и претрпела „проблеми со квалитетот што се вообичаени во ад хок цевководите“. Тоа е вистински напредок, а исто така е и тесен: 35 збирки на податоци, еден репер, едно ослободување.
Искрените граници се поважни за планирање отколку насловот. Ниту една анкета не дава единствен одбранлив процент на фер-усвојување за биофарма Р&Д, и ниту една студија не го брои процентот на трудови за откривање лекови за вештачка интелигенција со истекување или дефекти на репродуктивност. Затоа, секоја табела за подготвеност е помош за расудување, не е мерење.
⚠️ Предупредување: Третирајте го резултатот за подготвеност како структуриран почеток на разговор, не е потврдена метрика. Ако партнерот праша со кој резултат е спореден вашиот резултат, точниот одговор денес е „наши сопствени критериуми,“ не е објавен стандард.
Надворешната рамка пристигнува, иако. Јануари на ФДА 2025 нацрт-упатството за вештачката интелигенција во регулаторното одлучување предлага проценка на кредибилитет базирана на ризик, поврзана со наведен контекст на употреба. Тоа е нацрт, не за имплементација, и управува со поднесоците отколку со откривањето. Дури и така, укажува на прашањето на кое треба да се изгради програма за подготвеност: за што е овој модел, и кои докази го прават неговиот излез веродостоен за таа употреба?
Почеток: 30-дневна карта за подготвеност на податоци за пептиди
Работните текови на податоци за пептиди за откривање лекови со вештачка интелигенција се тестираат најбрзо со повлекување дваесет записи на пептиди по случаен избор и оценување на секоја од петте столба. Тоа е одлука од пет минути, и обично го решава прашањето дали програмата е подготвена за партнерство. Повеќето тимови сметаат дека мал број записи се чисти, поголема група е делумно комплетирана, а неколку не можат воопшто да се реконструираат.
За секое поле што не успева, одлучете дали јазот е проблем на фаќање или проблем на поврзување. Проблемот со снимање значи дека податоците никогаш не биле снимени, така што поправката е промена на она што го собира тимот на клупата. Проблемот со поврзувањето значи дека податоците постојат некаде, но не се споени со многу, метод, или отчитување на анализата, така што поправката е идентификатор и спојување, не е нов експеримент. Двајцата имаат различни сопственици и различни временски рокови, и третирањето на проблемот со поврзаноста како проблем за фаќање губи месеци.
Потоа поминете еден пептид низ целиот синџир од крај до крај: лична евиденција, сертификат за анализа поврзан со многу, Машински читлива аналитичка датотека. Документирајте ја секоја точка каде човек мораше да интервенира рачно. Таа интервентна листа е вистинскиот опсег на проектот за подготвеност.
Вообичаеното двоумење е дека ова бара замена на платформата. Во повеќето случаи тоа не го прави. Потребна е дисциплина на терен за записите што тимот веќе ги произведува.
Следен чекор: Извршете ја пропусницата за бодување со дваесет рекорди и доведете ја интервентната листа на преглед на подготвеност за технички податоци, каде што празнините се пресликуваат со конкретни поправки.
Најчесто поставувани прашања
Она што ја прави недвосмислена пептидната секвенца и записот за модификација?
Недвосмислен запис ја именува точната хемиска структура, не е стенографија што читателот треба да ја протолкува. Референтниот третман на нотацијата на структурата на пептидот третира хемиски приказ без загуби како примарен запис, со HELM што се користи за структури кои се свесни за полимер и SMILES за графички модели на ниво на атом, InChI или InChIKey како клучеви за дедупликација и идентитет, циклизација и вкрстени врски напишани како експлицитни објекти за поврзување, и неприродни остатоци напишани во шифри со повеќе букви со мали букви за D-амино киселини. Прибелешка за модификација на ниво на остатоци, како што се користи од MAP, одржува лактамски мост што се разликува од дисулфид. Запис кој вели „модифициран пептид“ без тој детал е чист, но не е подготвен за вештачка интелигенција.
Дали HELM или SMILES е подобар примарен рекорд?
Ниту едното ниту другото не е универзално подобро; изборот го следи моделот што ќе го потроши рекордот. HELM ја зачувува топологијата на ниво на полимер и чисто се справува со неприродни мономери и предмети за поврзување, што одговара на редоследната и макроциклистичка работа. SMILES дава графикон на ниво на атом што повеќето невронски мрежи и комплети алатки за хемиформатика директно го читаат. Програмите на кои им е потребно и едното да го складираат како примарен запис и да го генерираат другиот, со InChIKey како клуч за спојување, така што иста молекула никогаш не се брои двапати.
Колку е доволен контекст за анализа?
Доволно е што друга лабораторија може да го повтори мерењето и да го протолкува бројот. На минимум: тип на анализа и отчитување, цел и конструира, клеточна линија или матрица, опсег на концентрација, услови на инкубација, метод на откривање, и единиците. А 2025 систематскиот преглед на предвидувачите на епитоп покажа дека највисоко рангираниот епитоп може да ги врзува антителата in vitro, но сепак да биде слабо имуноген in vivo, и таа точност не се пренесува при читање, клеточната линија или целниот контекст се разликува. Обврзувачка вредност без контекст не може да се здружи со ништо.
Дали некогаш е прифатлив единствен број за чистота?
Само како наслов, никогаш како рекорд. I Q2(R2)Барањата за опсег на валидација го поставуваат известувањето за нечистотии од прагот до 120% на ограничувањето на спецификацијата, и површина на чистота проценти од 80% до 100% на границите на спецификацијата, со ограничувања за откривање и квантитација околу односот сигнал-шум од приближно 3:1 и 10:1. Податоците за нечистотијата на пептидите и историјата на сериите кои носат само „98% чисто“ кријат кои нечистотии, на кое ниво, со кој метод. Чувајте го бројот, потоа закачете го профилот зад него. Производство на пептиди За
Како ги споделуваме структурите со партнерот без да ја изложиме главната серија?
Споделете го моделот или изведените карактеристики наместо необработениот сет за обука, и тестирајте што открива излезот. Нападите за заклучок за членство што ги обновуваат молекулите за обука од опслужениот модел ги идентификуваат молекулите за обука само од излезните логити, а најранливи се молекулите од малцинската класа и ново-скелето, со комбинирани напади кои дополнително го зголемуваат ризикот. Ако на партнерот му се потребни самите податоци, користете контролирано опкружување со договорен сет на функции и ревизорска трага наместо пренос на датотека.
Дали моделот може да се потврди без независна парцела?
бр. Модел кој е потврден само на делови за кои веќе има забележано меморирање на извештаи, не генерализација. Задржете барем еден дел по програма, идеално од различна кампања за синтеза, и чувајте го недопрено до конечната евалуација. Доколку не постои независна жица, искрената изјава е дека моделот е внатрешно конзистентен, не е потврдена.
Дали нацрт-упатството на FDA се применува за работа во фаза на откривање?
Не директно, но тоа е најјасната достапна изјава за стандардот на кој на крајот ќе се држите. Јануари на ФДА 2025 нацрт-упатството за вештачката интелигенција во регулаторното одлучување предлага проценка на кредибилитет базирана на ризик, поврзана со наведен контекст на употреба. Тоа е нацрт датиран 6 јануари 2025 и не е за имплементација. Тимовите за откривање кои го документираат контекстот на употреба сега нема да мора да го реконструираат подоцна.
Клуч за носење: Тврдењето за подготвеност може да се одбрани само кога ги именува полињата за записи, архитектурата за споделување и протоколот за валидација, не кога пријавува број за чистота.
Заклучок
Подготвеноста е својство на рекордот, не од моделот, а тоа се работните текови на податоците од тестот за пептиди за откривање лекови со вештачка интелигенција што сега се соочува во секој разговор за партнерство. Петте столбови, unambiguous sequence and modification notation, assay context that travels with the result, impurity profiles rather than a single purity figure, lot-linked certificates of analysis, and machine-readable standardized analytical output, are the checklist. Confidentiality architecture and a written validation protocol are what let you share that record without handing over the lead.
The benchmark and regulatory frames are still forming: PepBenchmark 2026 is early, and the FDA draft guidance is not yet written for implementation. A readiness program built now answers a question partners will ask more formally later, so build it to be re-scored rather than certified once. This guide is a judgment aid, не е мерење. No defensible field-wide FAIR-adoption percentage or leakage-defect count exists, so a scorecard here supports a decision rather than settling one.
MOL Changes објавува како продавач на пептиди.
Откријте каде вашите записи со пептиди ќе го поништат моделот на партнерот. Прегледот за подготвеност за технички податоци ги мапира вашите записи на пептиди според петте столба и го класифицира секој јаз како проблем за снимање или проблем на поврзување. Побарајте преглед на подготвеноста за податоци со нашиот аналитички тим.