Welke workflows voor peptidegegevens voor het ontdekken van geneesmiddelen door AI eigenlijk nodig zijn
Peptidegegevensworkflows voor AI-medicijnontdekking zijn het bijhouden van gegevens, analytisch, en governancepraktijken die een peptidedataset machinaal bruikbaar maken door een voorspellend model. Ze bestrijken vijf gebieden: volgorde- en wijzigingsrecords, testcontext, onzuiverheidsgegevens, batchgeschiedenis, en gestandaardiseerde analytische resultaten. Wat ze onderscheidt van generieke data-gereedheidsadviezen is dat elke vereiste op het niveau van een individueel recordveld terechtkomt, en elk ervan moet zowel een vertrouwelijkheidsbeoordeling als een gedocumenteerd validatieprotocol overleven.
De recordniveaubalk is het onderdeel dat de meeste teams onderschatten. De referentiebehandeling van de notatie van de peptidestructuur houdt in dat machine learning-pijplijnen het beste werken vanuit een verliesvrije chemische representatie als primair record, met modelspecifieke coderingen die ervan zijn afgeleid in plaats van opgeslagen als de bron van de waarheid (Annotatie van peptidestructuren met behulp van SMILES en andere chemische codes, 2017). In die aanpak, InChIKey fungeert als identiteits- en deduplicatiesleutel, terwijl cyclisatie en verknopingen moeten worden geschreven als expliciete verbindingsobjecten in plaats van impliciet gelaten.
Toezichthouders bewegen zich in dezelfde richting. Januari van de FDA 2025 De ontwerprichtsnoeren over AI bij besluitvorming op regelgevingsgebied introduceren een op risico gebaseerde beoordeling van de geloofwaardigheid, gekoppeld aan een gedefinieerde gebruikscontext (FDA-ontwerprichtlijnen, inhoud actueel 2025-01-06). Het is een ontwerp, niet voor implementatie, maar het geeft aan dat AI-ready peptidedatasets zullen worden beoordeeld op traceerbaarheid in plaats van op volume.
Sleutel afhaalmaaltijd: Er zijn drie dingen die deze workflows onderscheiden van het gewone gegevensopschonen: recordvereisten op veldniveau, vertrouwelijkheidsmechanismen waarmee partners kunnen delen zonder een aanwijzing bloot te leggen, en een operationeel validatieprotocol in plaats van een vastgelegd principe.
Twee misvattingen veroorzaken de meeste verwarring. ‘Schone data’ betekent niet ‘curated data’, een opgeruimd spreadsheet kan nog steeds onbruikbaar zijn voor een model. En een enkel zuiverheidsgetal beschrijft geen peptide; onzuiverheids- en batchgeschiedenisgegevens bevatten de informatie waar een model daadwerkelijk van kan leren. Dit deel is gebaseerd op collegiaal getoetste structuurnotatieliteratuur en huidige regelgevingsrichtlijnen, zonder leveranciersbronnen.
Waarom workflows voor peptidegegevens voor het ontdekken van geneesmiddelen door AI nu belangrijk zijn
Peptidegegevensworkflows voor de ontdekking van geneesmiddelen door AI zijn van belang omdat het geld nu sneller beweegt dan de gegevens. In de 2026 AI-dealtracker gepubliceerd door VLS Research, onthulde upfront-clusters van $30-50 miljoen, tegenover nominale waarden van meer dan $1 miljard, ongeveer 2 à 3% van de totale waarde wordt in contanten betaald (VLS-onderzoek, AI-dealtracker voor het ontdekken van geneesmiddelen 2026, opgehaald 2026-07-03). Isomorphic Labs – Eli Lilly toont vooraf ongeveer $ 45 miljoen, tegen meer dan $ 1,7 miljard aan mijlpalen; Noetik-GSK toont vooraf $ 50 miljoen voor een licentiestructuur van vijf jaar. Noteer de bron: één analistentracker, met een leveranciersinteresse in het AI-dealverhaal.
Het klinische dossier is het tegenwicht. Rondom 90% van de moleculen die de kliniek binnenkomen, bereiken nooit goedkeuring, en 50-60% van de Fase II-mislukkingen is te wijten aan een gebrek aan werkzaamheid, cijfers die in twintig jaar nauwelijks zijn veranderd (Mao Z & Yan L, Grenzen in de farmacologie, opgehaald 2026-07-03). Hetzelfde 2024 systematische review van 20 AI-gestuurde programma's van 2018 naar 2023 ontdekte dat AI-ondersteunde leadoptimalisatie de screeningtijd van kandidaten gemiddeld met 30-50% verkortte, terwijl het verloop van fase I/II vergelijkbaar bleef met benchmarks in de sector.
Die kloof is het punt. Partners kunnen nu een model ondertekenen, maar een model kan niet leren van gegevens die het peptide nooit hebben vastgelegd.
Dit treft R&D leidt, analytische chemie, gegevens en IT, en de alliantiemanagers die na ondertekening diligence-vragen erven.
De vijf datapijlers van AI-ready peptidedatasets
AI-ready peptidedatasets zijn opgebouwd uit vijf pijlers op recordniveau, en samen vormen ze de gereedheidschecklist waaraan een team zichzelf kan scoren voordat ze een partnerschapsovereenkomst ondertekenen. Elke pijler hieronder is op dezelfde manier geschreven: waarom het ertoe doet, hoe je het moet implementeren, en hoe falen eruit ziet als het ontbreekt. De volgorde is bewust. Identiteit komt op de eerste plaats omdat elk stroomafwaarts veld, van testcontext tot onzuiverheidsprofiel, erft de fouten van een dubbelzinnig structuurrecord. Een model dat is getraind op een verkeerd gespecificeerde reeks faalt niet luid; het leert het verkeerde molecuul kennen en rapporteert er zelfverzekerde voorspellingen over.
Scoor elke pijler eerlijk. Een team dat elk peptide uit zijn eigen gegevens kan reconstrueren, koppel testvoorwaarden aan elk resultaat, en elke partij traceren naar een analysecertificaat, klaar om de gegevens aan een partner te overhandigen. Een team dat dat niet kan, wordt niet uitgesloten van samenwerking, maar verwacht mag worden dat de eerste maanden van de samenwerking zullen worden besteed aan gegevensherstel in plaats van aan modeltraining.
Pillen 1: Ondubbelzinnige volgorde- en wijzigingsrecords
Peptidesequentie- en modificatierecords zijn van belang omdat een model niet kan leren van een peptide dat het niet kan reconstrueren, en identiteitsfouten planten zich geruisloos voort door elke stroomafwaartse voorspelling. De oplossing is een verliesvrije chemische weergave als het primaire record, met modelspecifieke coderingen die ervan zijn afgeleid in plaats van opgeslagen als de bron van de waarheid.
De implementatie volgt een klein aantal conventies. HELM verwerkt polymeerbewuste structuren, inclusief takken en niet-natuurlijke monomeren, terwijl SMILES grafische modellen op atoomniveau bedient. InChI en InChIKey fungeren als deduplicatie- en identiteitssleutels voor verschillende systemen. Cyclisatie en verknopingen horen thuis in expliciete verbindingsobjecten, nooit als een impliciete veronderstelling dat ‘cyclisch’ overal hetzelfde betekent. De referentiebehandeling van de notatie van de peptidestructuur dekt de rest: meerlettercodes voor niet-eiwit- of niet-natuurlijke residuen, annotatie in kleine letters voor D-aminozuren, en annotatie van wijzigingen op residuniveau in MAP-formaat (Tijdschrift voor Cheminformatica / PMC).
De faalmodus is stil en duur. Een programma registreert een lactambrug en een disulfide als “gecycliseerd” in hetzelfde veld, dus behandelt het model twee chemisch verschillende steigers als één. Elke voorspelling die op die kolom is gebouwd, is besmet, en niets in de pijplijn markeert dit.
Een model-bruikbaar record voor een gemodificeerd macrocyclisch peptide bevat het onderstaande veld. MOL Changes ondersteunt deze structuur-eerste benadering in zijn peptidedatawerk, en het voorbeeld is repliceerbaar met elk conform registratiesysteem.
|
Veld |
Model-bruikbaar record |
Typisch vrijetekstrecord |
|---|---|---|
|
Primaire vertegenwoordiging |
HELM-reeks met expliciete verbindingsobjecten |
Volgorde geplakt in een notitieveld |
|
Codering op atomair niveau |
SMILES afgeleid van het HELM-record |
Afwezig |
|
Peptidesynthese Identiteitssleutel |
InChIKey voor deduplicatie |
Afwezig |
|
Niet-natuurlijk Synthetische peptiden residuen |
Codes met meerdere letters, gedefinieerd in een monomeertabel |
Benaderingen van één letter |
|
Stereochemie |
Annotatie van het D-aminozuur in kleine letters |
Niet opgenomen |
|
Wijzigingen |
MAP-annotatie op residuniveau |
Vrije tekst notitie, bijv. “gefietst” |
|
Cyclisatietype |
Expliciet brugobject met posities |
Ambigu |
|
Diensten Verknopingen |
Expliciet verbindingsobject |
Afwezig of impliciet |
Pillen 2: Assaycontext die met het resultaat meereist
Een bindingsaffiniteit zonder de bijbehorende testomstandigheden is geen trainingslabel, het is een getal. De testcontext moet met het resultaat meereizen: testtype, doelconstruct en soort, uitleesformaat, en of de waarde werd gemeten of voorspeld.
Het gemeten versus voorspelde onderscheid is waar de meeste datasets stilletjes breken. A 2025 uit een systematische review van epitoopvoorspellers bleek dat alleen maar 174 van 777 (22%) van computationeel voorspelde HLA-bindende peptiden in één SARS-CoV-2-onderzoek werd bevestigd dat ze in vitro stabiel binden (npj-vaccins, 2025-08-30). Dat cijfer is beperkt tot één onderzoek, geen algemeen nauwkeurigheidspercentage voor AI in de immunologie, maar het laat zien waarom een voorspelde waarde en een gemeten waarde geen kolom kunnen delen zonder een vlag die ze scheidt.
⚠️Waarschuwing: Poolen SPR, fluorescentiepolarisatie en celgebaseerde waarden in één affiniteitskolom trainen het model op de test in plaats van op de chemie. Het model leert welk laboratorium het nummer heeft gegenereerd, niet welk peptide bindt.
Pillen 3: Onzuiverheidsprofielen, Geen enkel zuiverheidsgetal
Peptide-onzuiverheids- en batchgeschiedenisgegevens horen als profiel in het record, geen koppercentage. Twee percelen gemeld bij 98% pure kan zich anders gedragen in een test, en het model heeft de onzuiverheidsomhulling en de tegenionstatus nodig om te zien waarom.
Tegenioneffecten zijn goed gedocumenteerd. In een 2025 beoordeling, het M33-peptide als een TFA-zout vertoonde 5-30% grotere cytotoxiciteit voor normale bronchiale epitheelcellen dan de acetaat-tegenhanger, en MOG-peptide geformuleerd met TFA werd ruwweg geassocieerd met het begin van encefalomyelitis 5 dagen eerder met een vergelijkbare incidentie en ernst (Biomoleculen, 2025-11-07). Uit een afzonderlijk onderzoek bleek dat chloride van de geteste anionen het minst efficiënt was bij het induceren van de spiraalvormige structuur in LL-37 (Farmaceutische producten / Moleculen, 2020-12-03). Dit zijn formuleringsafhankelijke waarnemingen, geen algemene verklaring dat elk tegenvoorstel onveilig is.
Implementatie betekent het opslaan van de retentietijden van onzuiverheden, relatieve gebieden en de tegenionenuitwisselingsstatus naast het zuiverheidscijfer. Voor validatielagen, ik Q2(R2) stelt het validatiebereik in in plaats van de limieten voor de zuiverheid van peptiden: Het testen op onzuiverheden moet de rapportagedrempel tot maximaal dekken 120% van de specificatielimiet, en de zuiverheid per oppervlaktepercentage wordt gevalideerd 80% van de lagere tot 100% van de bovenste specificatielimiet (ik Q2(R2), definitieve richtlijn 2023-11-30).
Pillen 4: Batchgeschiedenis en partijgekoppelde analysecertificaten
Modelvertrouwen is een traceerbaarheidseigenschap, vandaar de lotnummers, De koppeling van analysecertificaten en de geschiedenis van hertesten horen thuis in de dataset en niet alleen in het kwaliteitsmanagementsysteem. De ALCOA+-verwachtingen waaraan AI/ML-pijpleidingen nu moeten voldoen, zijn een reeds bestaande GMP-standaard die is uitgebreid naar een nieuw gebruiksscenario, geen nieuwe regel uitgevonden voor modellen. Data-afstamming wordt aangemerkt als een cruciaal punt van zorg nu AI/ML integreert met MES en LIMS, en de digitale draad wordt gedefinieerd als de ononderbroken keten van gegevensrelaties, vanaf het testen van grondstoffen via de productie tot de release van het eindproduct (Regelgevingsperspectieven voor de implementatie van AI/ML, PMC, 2025-06-16).
Voor Tip: Bewaar de geschiedenis van opnieuw testen en testen in plaats van te overschrijven Winkel Het. Een vervangen waarde met een tijdstempel is bewijs; een vervangen waarde is een gat.
De faalmodus is een dubbelgetelde campagne. Drie assays die op dezelfde partij worden uitgevoerd, worden ingevoerd als drie onafhankelijke waarnemingen, en het model behandelt één batch als drie, het vergroten van het vertrouwen in een resultaat dat nooit werd herhaald.
Pillen 5: Gestandaardiseerde analytische resultaten en machinaal leesbare formaten
Gestandaardiseerde analytische resultaten voor peptide AI zijn afhankelijk van formaten die een pijplijn kan parseren zonder handmatig opschonen. Voor de analytische laag bestaan al machinaal leesbare standaarden: mzML voor onbewerkte massaspectrometriegegevens, mzIdentML en mzTab voor identificaties en kwantificering, PX-XML voor metagegevens van inzendingen, SDRF-Proteomics voor monster- en blootstellingsrelaties, en USI voor stabiele spectrumidentificatoren (Proteomics-data-infrastructuur).
Reproduceerbaarheid vereist ook het volledige methodeblok. Parameters van de HPLC-methode omvatten kolomchemie (typisch C18), deeltjes- en poriegrootte, afmetingen van kolommen, mobiele fasen en modificatoren, gradiënt programma, stroomsnelheid (rondom 1.0 ml/min analytisch), kolom temperatuur, detectie golflengte (typisch 214–220 nm voor peptiden) en injectiehoeveelheid. Identiteit moet worden bevestigd door LC-MS of MALDI-TOF met intacte massa met waargenomen versus theoretische massa en een aangegeven acceptatievenster in ppm of Da, niet alleen door HPLC (Fenomenex HPLC kenniscentrum, 2026-07-29).
De faalmodus is een record met de tekst ‘standaard RP-HPLC-gradiënt’. Zonder het methodeblok, het resultaat kan niet als validatie-anker dienen, en een partner kan het niet reproduceren.
Vertrouwelijkheid: Peptidegegevens delen zonder de leiding te lekken
Het vertrouwelijkheidsrisico bij AI-peptidepartnerschappen is meetbaar, niet theoretisch. A 2025 Uit onderzoek naar neurale netwerken voor de ontdekking van geneesmiddelen is gebleken dat in een black-box-scenario waarin alleen outputlogits zichtbaar zijn, zoals een model dat als webservice wordt aangeboden, Aanvallen op het gebied van lidmaatschapsinferentie identificeerden welke chemische structuren in de trainingsset aanwezig waren, en het combineren van verschillende aanvallen verhoogde het risico (Het publiceren van neurale netwerken bij de ontdekking van geneesmiddelen kan de vertrouwelijkheid in gevaar brengen, 2025-03-26). De auteurs merken op dat moleculen uit minderheidsklassen komen, vaak het meest waardevol bij het ontdekken van geneesmiddelen, zijn bijzonder kwetsbaar, en dat unieke structuren die verschillen van gevestigde bibliotheekverbindingen mogelijk overeenkomen met eigen aanknopingspunten of nieuwe scaffolds in ontwikkeling.
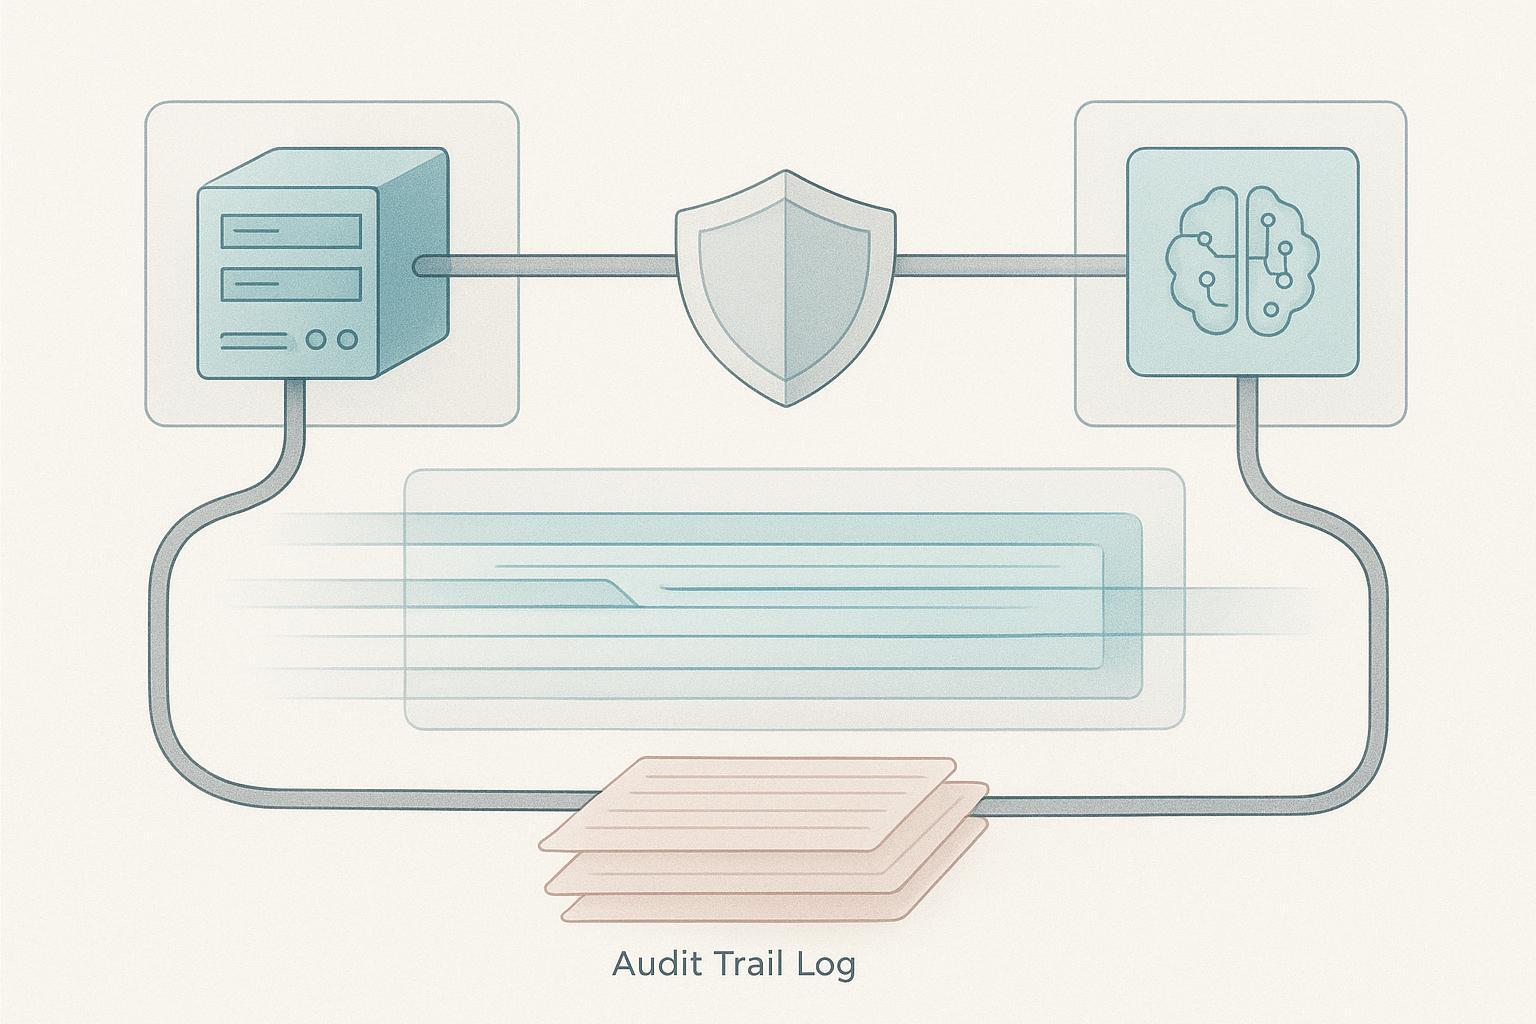
De operationele reactie is een gelaagd toegangsmodel in plaats van een enkel besluit over het delen van gegevens. Sponsors houden de ruwe gegevens intern bij; de partner ontvangt geanonimiseerde of gehashte representaties waar de modelleringstaak dit toelaat; alleen de totale output verlaat de samenwerking. Contractuele beperkingen van wat de partner mag behouden, plus een audittrail voor elke zoekopdracht op de gedeelde set, sluit de lus.
Sleutel afhaalmaaltijd: De-identificatie vermindert het lekkagerisico, maar elimineert dit niet voor structureel onderscheidende peptiden, dus tiering en query-auditing dragen het gewicht dat maskering alleen niet kan.
Wetenschappelijke validatie: Een operationeel protocol, Geen principe
Validatie is geen principe waar u het mee eens bent. Het is een reeks die je uitvoert: eerst orthogonale bevestiging, vervolgens onafhankelijke replicatie, vervolgens afstemming van elke modelgerichte waarde terug naar de ruwe analytische gegevens waar deze vandaan kwam. Het overslaan van de derde stap is de meest voorkomende fout, omdat een afgestemd getal en een niet-afgestemd getal er identiek uitzien in een trainingstabel.
Definieer het orthogonale paar per claimtype voordat u iets genereert. Voor identiteit, koppel intacte massa aan een tweede, mechanisch verschillende methode in plaats van een herhaalde injectie op hetzelfde instrument. Voor activiteit, combineer een biofysische bindingsuitlezing met een celgebaseerde functionele uitlezing, omdat de twee verschillende vragen beantwoorden.
Voor de replicatie moet een onafhankelijk gesynthetiseerde partij worden gebruikt, geen herhaling van hetzelfde materiaal. Door dezelfde test twee keer op dezelfde partij uit te voeren, wordt de nauwkeurigheid van het instrument gemeten, geen generalisatie. A 2025 uit een systematische review van methoden voor het voorspellen van epitoop is gebleken dat veel huidige benaderingen lijden onder overaanpassing van hun trainingsdatasets, wat drastisch beperkt hoe goed ze overgaan naar nieuwe doelen (npj-vaccins, 2025-08-30). In hetzelfde overzicht wordt opgemerkt dat niet alle bindmiddelen immunogeen zijn: een epitoop van de hoogste rang kan in vitro aan antilichamen binden, maar er in vivo niet in slagen de beoogde respons op te wekken, en de nauwkeurigheid op een benchmark wordt niet overgedragen bij de uitlezing, cellijn, of doelcontext verschilt.
Dat is de faalwijze waar we tegen moeten ontwerpen. Een validatieset uit dezelfde campagne als de trainingsset meet het onthouden, geen generalisatie.
De benchmarkkloof: Wat standaardisatie nog steeds niet kan oplossen
Standaardisatie is noodzakelijk, maar niet voldoende. De benchmarks van het vakgebied zijn nieuw en beperkt, en geen enkele scorekaart kan nog meten wat hij beweert te meten.
PepBenchmark, de gestandaardiseerde peptide-ML-benchmark die in april werd uitgebracht 2026 en gepresenteerd op ICLR 2026, dekt 29 canoniek-peptide plus 6 niet-canonieke-peptide-datasets over 7 groepen, met een uniforme voorverwerkingspijplijn en een scorebord dat vier methodefamilies omvat: Vingerafdruk, GNN, PLM, en GLIMLACHEN. De auteurs stellen duidelijk dat eerder werk “gehinderd werd door de afwezigheid van gestandaardiseerde benchmarks” en te kampen had met “kwaliteitsproblemen die gebruikelijk zijn bij ad hoc pijpleidingen.” Dat is een echte vooruitgang, en het is ook nog eens smal: 35 datasets, één maatstaf, één uitgave.
De eerlijke grenzen zijn belangrijker voor de planning dan de kop. Geen enkel onderzoek geeft één verdedigbaar FAIR-adoptiepercentage voor biopharma R&D, en geen enkele studie telt het aandeel AI-medicijnontdekkingspapieren met lekkage- of reproduceerbaarheidsdefecten. Elke gereedheidsscorekaart is daarom een beoordelingshulpmiddel, geen meting.
⚠️Waarschuwing: Beschouw een gereedheidsscore als een gestructureerde gespreksaanzet, geen gevalideerde maatstaf. Als een partner vraagt waar uw score mee wordt vergeleken, het juiste antwoord vandaag is “onze eigen criteria,”geen gepubliceerde standaard.
Het externe frame arriveert, hoewel. Januari van de FDA 2025 De ontwerprichtsnoeren over AI bij besluitvorming op regelgevingsgebied stellen een op risico's gebaseerde geloofwaardigheidsbeoordeling voor, gekoppeld aan een bepaalde gebruikscontext. Het is een ontwerp, niet voor implementatie, en het regelt inzendingen in plaats van ontdekkingen. Toch, het wijst op de vraag waarvoor een gereedheidsprogramma moet worden ontwikkeld: waar is dit model voor, en welk bewijsmateriaal de output ervan geloofwaardig maakt voor dat gebruik?
Aan de slag: Een 30-daagse peptidegegevensgereedheidspas
Workflows voor peptidegegevens voor het ontdekken van geneesmiddelen met AI worden het snelst getest door willekeurig twintig peptiderecords te verzamelen en deze allemaal te scoren op basis van de vijf pijlers. Dat is een beslissing van vijf minuten, en het beantwoordt meestal de vraag of een programma klaar is voor een partnerschap. De meeste teams vinden dat een handvol records schoon is, een grotere groep is gedeeltelijk compleet, en enkele kunnen helemaal niet worden gereconstrueerd.
Voor elk veld dat faalt, beslissen of de kloof een vangprobleem of een koppelingsprobleem is. Een vastlegprobleem betekent dat de gegevens nooit zijn vastgelegd, dus de oplossing is een verandering in wat het team op de bank verzamelt. Een koppelingsprobleem betekent dat de gegevens ergens bestaan, maar niet aan veel gegevens zijn gekoppeld, een methode, of een testuitlezing, dus de oplossing is een identificatie en een join, geen nieuw experiment. De twee hebben verschillende eigenaren en verschillende tijdlijnen, en het behandelen van een koppelingsprobleem als een vangprobleem is een verspilling van maanden.
Voer vervolgens één peptide van begin tot eind door de volledige keten: identiteitsbewijs, partijgebonden analysecertificaat, machinaal leesbaar analytisch bestand. Documenteer elk punt waarop een mens met de hand moest ingrijpen. Die interventielijst is de werkelijke reikwijdte van het paraatheidsproject.
De algemene aarzeling is dat hiervoor het platform moet worden vervangen. In de meeste gevallen niet. Het vereist discipline op veldniveau voor de records die het team al produceert.
Volgende stap: Voer de scorepas voor twintig records uit en breng de interventielijst naar een technische beoordeling van de gereedheid van de gegevens, waar de gaten worden toegewezen aan concrete oplossingen.
Veelgestelde vragen
Wat maakt een peptidesequentie en modificatierecord ondubbelzinnig?
Een ondubbelzinnig record geeft de exacte chemische structuur aan, geen afkorting die een lezer moet interpreteren. De referentiebehandeling van de peptidestructuurnotatie behandelt een verliesvrije chemische representatie als het primaire record, waarbij HELM wordt gebruikt voor polymeerbewuste structuren en SMILES voor grafiekmodellen op atoomniveau, InChI of InChIKey als deduplicatie- en identiteitssleutels, cyclisatie en crosslinks geschreven als expliciete verbindingsobjecten, en niet-natuurlijke residuen geschreven in meerletterige codes met kleine letters voor D-aminozuren. Annotatie van wijzigingen op residuniveau, zoals gebruikt door MAP, zorgt ervoor dat een lactambrug onderscheidbaar is van een disulfide. Een record waarop zonder dat detail ‘gemodificeerd peptide’ staat, ziet er strak uit, maar is niet AI-ready.
Is HELM of SMILES het betere primaire record?
Geen van beide is universeel beter; de keuze volgt het model dat de plaat zal consumeren. HELM behoudt de topologie op polymeerniveau en gaat netjes om met niet-natuurlijke monomeren en verbindingsobjecten, wat past bij sequentiebewust en macrocycluswerk. SMILES biedt een grafiek op atoomniveau die door de meeste grafische neurale netwerken en schei-informaticatoolkits direct kan worden gelezen. Programma's die beide nodig hebben, slaan het ene op als het primaire record en genereren het andere, met InChIKey als verbindingssleutel, zodat hetzelfde molecuul nooit twee keer wordt geteld.
Hoeveel testcontext is voldoende?
Genoeg dat een ander laboratorium de meting zou kunnen herhalen en het getal zou kunnen interpreteren. Minimaal: assaytype en uitlezing, richten en construeren, cellijn of matrix, concentratie bereik, incubatieomstandigheden, detectie methode, en de eenheden. A 2025 uit een systematische review van epitoopvoorspellers is gebleken dat een epitoop met de hoogste rangorde in vitro antilichamen kan binden, maar in vivo slecht immunogeen kan zijn, en die nauwkeurigheid wordt niet overgedragen bij het uitlezen, cellijn- of doelcontext verschilt. Een bindende waarde zonder context kan met niets worden gecombineerd.
Is een enkel zuiverheidsgetal ooit acceptabel??
Alleen als kop, nooit als record. ik Q2(R2)De vereisten voor het validatiebereik bepalen de rapportage van onzuiverheden vanaf de drempel tot 120% van de specificatielimiet, en zuiverheidsoppervlaktepercentage van 80% naar 100% van specificatielimieten, met detectie- en kwantificatielimieten rond signaal-ruisverhoudingen van ongeveer 3:1 En 10:1. Gegevens over peptide-onzuiverheden en batchgeschiedenis die slechts “98% zuiver” bevatten, verbergen welke onzuiverheden, op welk niveau, volgens welke methode. Bewaar het nummer, bevestig vervolgens het profiel erachter. Peptideproductie Over
Hoe delen we structuren met een partner zonder de hoofdreeks bloot te leggen?
Deel het model of de afgeleide functies in plaats van de onbewerkte trainingsset, en test wat de output onthult. Aanvallen op basis van lidmaatschapsinferentie die trainingsmoleculen uit een aangeboden model herstellen, identificeren trainingsmoleculen alleen uit uitvoerlogits, en moleculen uit minderheidsklassen en nieuwe scaffolds zijn het meest kwetsbaar, waarbij gecombineerde aanvallen het risico verder vergroten. Als een partner de gegevens zelf nodig heeft, gebruik een gecontroleerde omgeving met een overeengekomen functieset en een audittrail in plaats van een bestandsoverdracht.
Kan een model worden gevalideerd zonder een onafhankelijk lot??
Nee. Een model dat alleen is gevalideerd op percelen die het al heeft gezien, rapporteert memorisatie, geen generalisatie. Houd minimaal één lot per programma achter, idealiter uit een andere synthesecampagne, en laat het onaangeroerd tot de eindevaluatie. Als er geen onafhankelijk perceel bestaat, de eerlijke verklaring is dat het model intern consistent is, niet gevalideerd.
Zijn de ontwerprichtlijnen van de FDA van toepassing op werkzaamheden in de ontdekkingsfase??
Niet direct, maar het is de duidelijkste beschikbare verklaring van de norm waaraan u uiteindelijk zult worden gehouden. Januari van de FDA 2025 De ontwerprichtsnoeren over AI bij besluitvorming op regelgevingsgebied stellen een op risico's gebaseerde geloofwaardigheidsbeoordeling voor, gekoppeld aan een bepaalde gebruikscontext. Het is een gedateerd ontwerp 6 Januari 2025 en is niet voor implementatie. Ontdekkingsteams die de gebruikscontext nu documenteren, hoeven deze later niet te reconstrueren.
Sleutel afhaalmaaltijd: Een gereedheidsclaim is alleen verdedigbaar als de recordvelden worden benoemd, de deelarchitectuur en het validatieprotocol, niet wanneer het een zuiverheidsgetal rapporteert.
Conclusie
Gereedheid is een eigenschap van het record, niet van het model, en dat zijn de workflows voor testpeptidegegevens voor de ontdekking van geneesmiddelen met AI die nu in elk partnerschapsgesprek worden geconfronteerd. De vijf pijlers, ondubbelzinnige volgorde en wijzigingsnotatie, testcontext die met het resultaat meereist, onzuiverheidsprofielen in plaats van één enkel zuiverheidscijfer, partijgebonden analysecertificaten, en machinaal leesbare gestandaardiseerde analytische output, zijn de checklist. Dankzij de vertrouwelijkheidsarchitectuur en een schriftelijk validatieprotocol kunt u dat record delen zonder de leiding over te dragen.
De benchmark- en regelgevingskaders zijn zich nog steeds aan het vormen: PepBenchmark 2026 is vroeg, en de ontwerprichtlijnen van de FDA zijn nog niet geschreven voor implementatie. Een nu ontwikkeld gereedheidsprogramma geeft antwoord op een vraag die partners later formeler zullen stellen, bouw het dus zodat het opnieuw wordt gescoord in plaats van één keer te worden gecertificeerd. Deze gids is een beoordelingshulpmiddel, geen meting. Er bestaat geen verdedigbaar veldbreed FAIR-adoptiepercentage of lekkage-defecttelling, dus een scorekaart ondersteunt hier een beslissing in plaats van er een te vereffenen.
MOL Changes publiceert als peptideleverancier.
Ontdek waar uw peptiderecords zouden falen in het model van een partner. Een technische beoordeling van de gegevensgereedheid brengt uw peptiderecords in kaart aan de hand van de vijf pijlers en classificeert elke leemte als een vangprobleem of een koppelingsprobleem. Vraag een beoordeling van de gegevensgereedheid aan met ons analytisch team.