Брз одговор
Think of precursor selection as a sampling strategy rather than a detector setting. A detector reports what reaches it; the sampling strategy decides what gets…
Што всушност менува напредната селекција на јони прекурсори во споредба со конвенционалните TopN DDA?
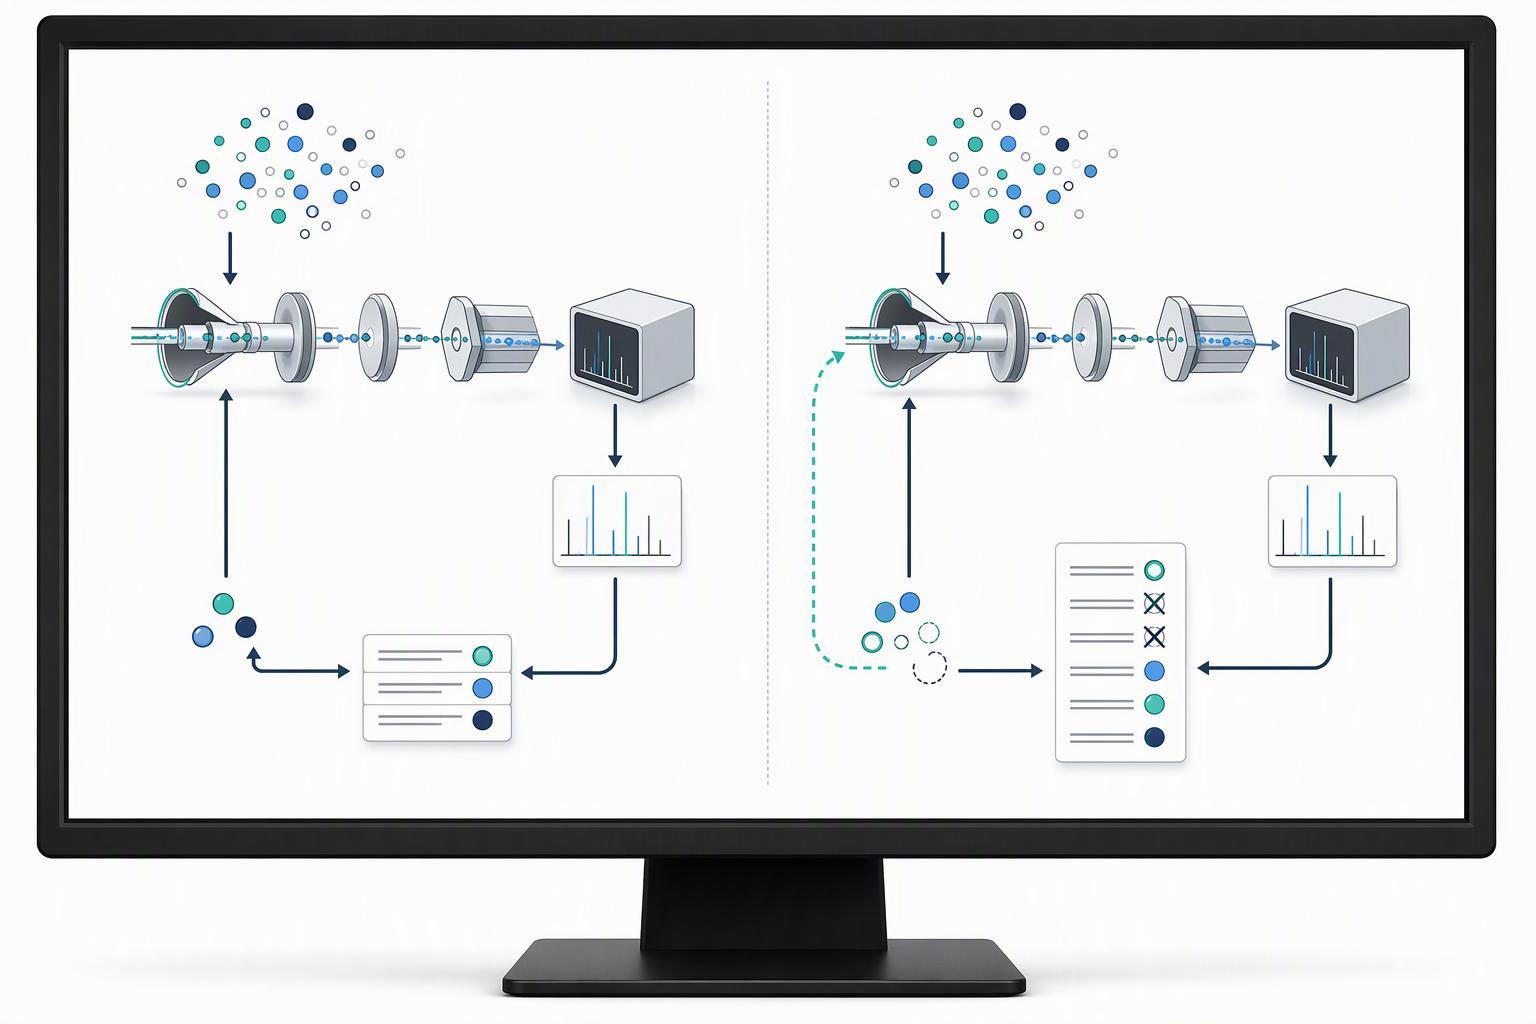
Синтетички пептид Пептиди Хормони за раст Ја менува јамката за земање примероци, не детекторот. Конвенционалниот TopN DDA ги избира N најинтензивните прифатливи прекурсори во секој циклус MS1, а динамичкото исклучување го спречува итно реизборот, така што селекцијата останува главно водена од интензитетот и изобилството на пептиди се земаат повторно и повторно (Крејмер и сор., J Proteome Res, 2016). Инструментот работи правилно; стратегијата едноставно продолжува да се враќа во истото соседство.
Крејмер и сор. спореди две стратегии за итеративно-исклучување: исклучувајќи ги сите претходно фрагментирани прекурсори и исклучувајќи ги само идентификуваните пептиди. Ова се различни дизајни со различни резултати. Опишете која листа на исклучување била користена пред да ја цитирате добивката, и да го задржат опсегот на HeLa дигестот на студијата и LTQ Orbitrap XL. Оригинална студија.
Третата варијанта дополнително го турка исклучувањето: пребарувањето на базата на податоци во реално време за време на стекнувањето овозможува исклучување според идентитетот на пептидот наместо со m/z и временски настан. Раната симулациска работа на адаптивната селекција на врвови покажа дека ова е додадено најмногу околу a 1% добивка во однос на стандардниот избор на листа за исклучување (arXiv претходно печатење 1207.5848, н.д.). Третирајте го тој број како резултат на симулација, не е репер, и не го цитирај како измерен исход од инструментот.
Во цитираниот 2016 проучување, конвенционалната TopN заситеност во близина 12,500 уникатни пептиди беше екстраполација. Комбинираните експерименти со итеративно-исклучување се надминати 16,000 идентификации. Споредбата илустрира комплементарно земање примероци според тој дизајн, не е универзален 29% добивка во текот на усогласената контрола со едно возење.
Пребарувањето на ко-изолирани видови може да ја зголеми длабочината на идентификацијата во наведените 2025 проучување. Неговите пријавени проценти користат различни споредби и мора да ги задржат своите сопствени именители; тие не треба да се комбинираат во просек што го надминува наведениот опсег или да се спојат со добивки од итеративно исклучување.
Изборот на претходник влијае на тоа кој доказ за фрагментација ќе се добие. Нефрагментирана карактеристика сè уште може да биде присутна во податоците на MS1; не може да се додели доверливост на еквивалентна низа без соодветни докази. Подобреното пребарување може да ги врати информациите кои се веќе присутни во стекнатите спектри.
Зошто техничко-репликативното преклопување може да биде ниско без методот да биде неповторлив?
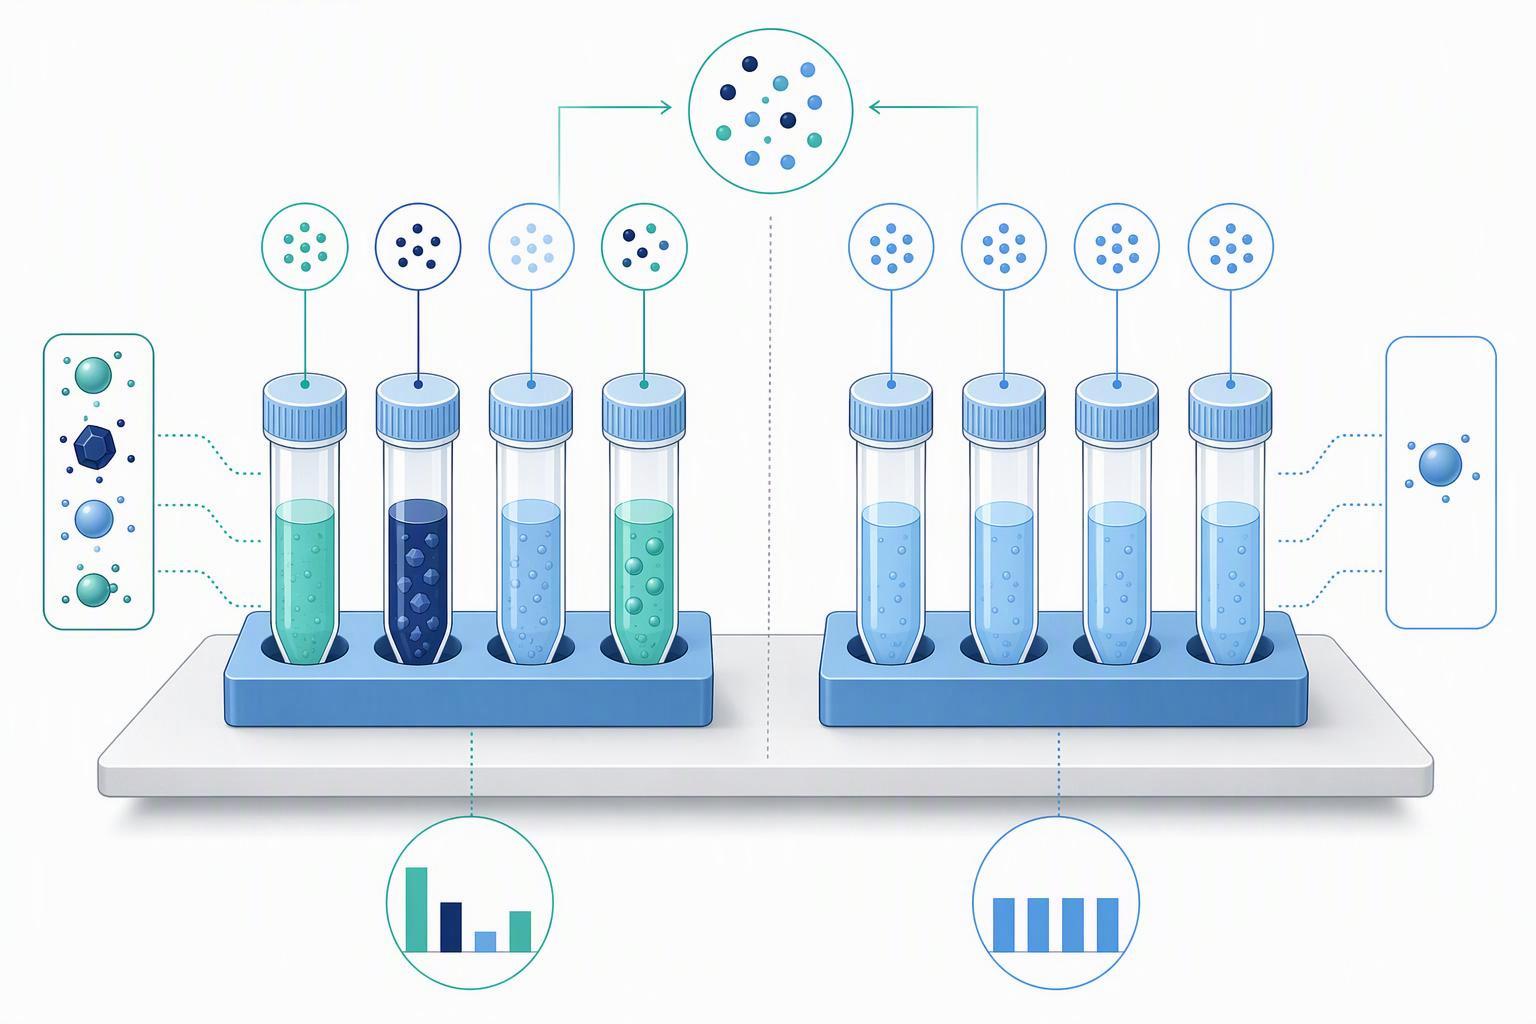
Бидејќи ниското преклопување и слабата репродуктивност се различни мерења, а дизајнот со длабочина на откривање може да го произведе првиот додека методот останува совршено повторлив. Долготрајниот опсег за преклопување на реплика на пептиди во конвенционалните DDA е 35-60% помеѓу парови технички реплики, фигура која доаѓа од а 2010 повторна анализа на LTQ и постари инструменти Orbitrap (Таб и сор., J Proteome Res, 2010). Таа студија исто така покажа дека преклопувањето е независно од сложеноста на примерокот: мешавина од 48 протеини даде средна вредност 44% се преклопуваат, стандардна протеинска смеса 46%, и дигест од квасец 45% (Таб и сор., J Proteome Res, 2010). Повторливоста е во корелација со интензитетот на претходниците, па пептидите со ниска изобилство беа оние кои испаднаа.
Тоа е клучната разлика. Ако вашиот репликативен дизајн го држи примерокот константен и не варира ништо друго освен инјектирањето, ниското преклопување значи дека методот стохастички зема примероци, што се очекува за ДДА. Ако вашиот дизајн е наменет да покаже репродуктивност, треба да наведете што се одржува константно, а што варира, и насоките за автор на MCP го бараат токму тоа: бројот на реплики стекнати со јасна разлика помеѓу биолошки, процесни и технички реплики, плус методот и видот на рандомизација, технички контроли, и временскиот распон на анализа на примерокот (MCP инструкции до авторите).
Два неодамнешни независни експерименти покажуваат колку од проблемот на преклопување зависи од стекнувањето. Директната споредба DDA-наспроти-DIA во истите примероци откри повеќе од 92% на пептиди конзистентно идентификувани низ репликите во податоците на DIA наспроти помалку од 77% во податоците на DDA, со конзистентност на ниво на протеини на 99.0/98.2/98.2% за ДИА против 95.6/95.4/96.2% за ДДА (PMC12801617, 2025). Споредбата на комплетноста со осум реплики во солзавната течност пронајдена ДИА кај 78.5% комплетноста на пептидите наспроти 48% за ДДА, со средна биографија на 10.6% и 22.3% соодветно (J Mass Spectrom Adv Clin Lab, 2025). Две различни метрики, конзистентност на присуство/отсуство и коефициент на варијација, посочете на ист начин.
Искрениот јаз: ниту еден извор во овој сет повторно не го мери 2010 фигура на преклопување на тековната инструментација. Опсегот од 35–60% треба да се датира секогаш кога ќе се цитира, а доказите DIA-versus-DDA опфаќаат само клеточни линии и солза течност. Ниту еден извор овде не ги споредува двата режима на фосфопротеом или друг примерок збогатен со PTM, така што секое тврдење за DIA наспроти DDA за модифицирани пептиди би било неподдржано.
Пред стекнување, разликуваат дизајн на длабочина на откритие од студија за повторливост. Ниското преклопување по намерното исклучување може да укаже на комплементарно земање примероци, но и проверете ја довербата во идентификацијата, вкупна покриеност и квалитет на примерокот; Самото ниско преклопување не докажува дека стратегијата функционира.
Колку покриеност низа е доволна, и каде мора да падне покриеноста?
Дефинирајте ја метриката на покриеност пред да поставите критериум. Покриеноста на протеинската секвенца ги брои остатоците претставени со идентификувани пептиди; фрагмент-јонската покриеност на синтетички пептид е различна мерка. Ниту еден процент сам не го воспоставува редот на остатоци, позиција на модификација или стереохемија. Поставете ги потребните дијагностички јони и ортогонални тестови за конструкцијата.
Од таа дефиниција произлегува правилото за поставување. За модифициран или означен пептид, покриеноста треба да го вклучи остатокот што ја носи модификацијата или етикетата. А 95% мапа на покриеност што ја остава изменетата локација непокриена 5% не поддржува приговор за идентитет специфичен за локацијата, колку и да изгледа висок процентот.
Тоа е практика на продавачите, не е регулаторен праг, и тоа треба да биде означено како такво во секоја спецификација што ќе ја напишете.
Она што рецензентот всушност може да ве заложи е комплетот за известување. Упатството за списанието кое може да го држи читателот бара толеранција на маса на прекурсор-јони и фрагмент-јони, пребарувачот и верзијата, базата на податоци, методот на проценка на FDR, и софтверот или методот што се користи за оценување на доделувањето на локацијата за модификација, со означени спектри за секој пептид каде што е пријавено место за модификација (Упатство за MCP за поднесување податоци на Proteomics, Упатство за автор на MCP). Списокот за проверка со минимални информации го додава името на софтверот, верзија и производител, побарани бази на податоци со верзии и брои за влез, и датотеките со параметрите (MIAPE-MSI 1.1, 2008-02-05). MIAPE е 2008 листа за проверка и останува на верзијата 1.1; тоа не е ново барање.
Значи, практичниот одговор на „кој број на покриеност ќе го прифати рецензентот“ е: наведете го прагот што сте го примениле, држава каде покриеноста паѓа во однос на Семаглутид пептид модифицираниот остаток, и пријавете ги параметрите што дозволуваат некој да ја репродуцира пресметката. Бројка без тие три работи не може да се одбрани.
Како да локализирате модификација или етикета наместо само да ја потврдите недопрената маса?
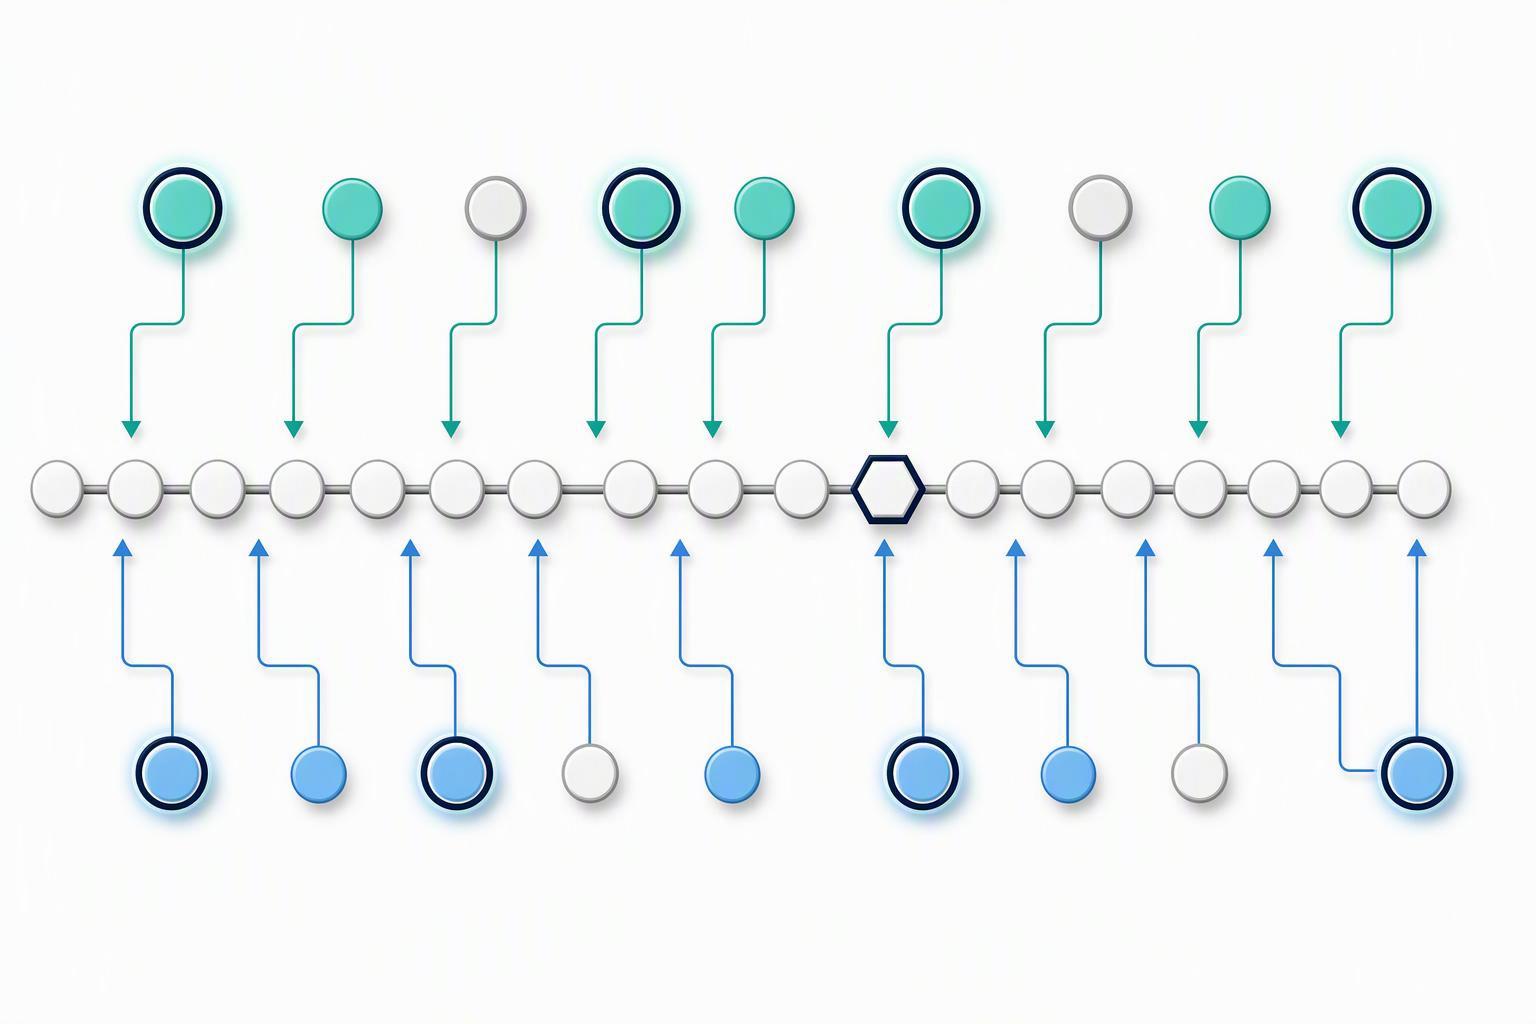
Локализацијата е посебно мерење од идентификацијата, со свој резултат, сопствен праг и сопствена стапка на грешка. Комбинаторната основа зошто масата сама не може да го затвори барањето за идентитет е стара и цврста: меѓу пептидите кои се разликуваат по состав за еден, две или три аминокиселини, 10%, 29% и 53% соодветно имаат масовно идентични изомери, и со исклучок на изомерите на леуцин/изолеуцин, бројките се 14% и 38% (Тој и сор., J Proteome Res, 2004). Тие изомерни пептиди не можат да се разликуваат по маса, и потребни се тандем масена спектрометрија или други дополнителни ограничувања.
Резултатите за локализација функционираат со споредување на фрагменти што ја одредуваат локацијата. Тековната имплементација го споредува пептидоформот со најдобар резултат со модификацијата на локација против пептидоформот со најдобар резултат без него, ги игнорира заедничките врвови бидејќи тие не обезбедуваат дискриминација, и ја поттикнува довербата за локализација само од дискриминирачки врвови (PTMPпророк, 2019). Таа имплементација примени локализација на праговите на веројатност на iProphet 0.9 за две сетови на податоци и 0.8 за една третина, вториот што одговара на 0.4% проценета грешка на PSM и 97.9% Чувствителност на PSM, и пријавени резултати во 5% стапка на лажна локализација и подолу 1% FLR (PTMPпророк, 2019).
Класичните прагови за локализација се засноваат на резултат и не треба да се третираат како универзални критериуми за прифаќање. AScore 19 одговара на p приближно 0.01, или 99% сигурност, а подоцна и фосфопротеомската практика од истата лабораторија користела полиберална стр < 0.05, AScore > 13; Spectrum Mill бара разлика во бодовите поголема од 1.1 помеѓу првите две локализации за сигурна локализација (Оценување за локализација на локацијата за модификација, 2012). Истиот преглед предупредува дека резултатите засновани на веројатност се потпираат на нереална претпоставка дека сите маси се подеднакво веројатно да се набљудуваат по случаен избор, и препорачува да се третираат како резултати кои подлежат на праг поставен од корисникот наместо како точни мерки на сигурност.
Тоа предупредување се потврдува со тоа како всушност се избираат праговите. PTMProphet го опишува изборот на прагот на веројатност за локализација како главно произволен избор направен од корисникот, да се постави според стапката на грешка што корисникот ја прифаќа (PTMPпророк, 2019). Ниту еден стандард не поправа број, така што одбранлив потег е да се наведе прагот, наведете ја стапката на грешка на која одговара, и пријавете ја стапката на локализација заедно со стапката на идентификација.
За означен пептид, очекуваното поместување на недопрена маса поддржува предложен состав, но не ја докажува хемијата на етикетата или местото на прикачување. Користете фрагменти за одредување на локацијата и, каде што е потребно, ортогонален структурен метод за тестирање на предложената ознака и поврзаност.
Која ортогонална техника на кое идентитетско прашање одговара?
Секоја техника одговара на различно прашање, а мапирањето е повеќе важно од пребројувањето. На 2025 Европско упатство за синтетички пептиди, во сила од јуни 2026, препорачува употреба на најмалку два ортогонални методи за идентификација како дел од спецификацијата и ослободувањето, и наведува маса, релативно време на задржување, LC-MS, мапирање на пептиди, биоактивност, анализа на аминокиселини или NMR како што е соодветно, со потребната комбинација за недвосмислено да се потврди низата (ЕМА, Упатство за развој и производство на синтетички пептиди, 2025-12-04, ефективни 2026-06-01).
Регулаторната логика одоздола е базирана на перформанси наместо нумеричка. I Q2(R2) бара идентификација за да се покаже способноста да се разликува аналитот според уникатни аспекти на молекуларна структура, потврдено со позитивни резултати во однос на референтниот материјал плус негативни резултати од примероци на кои му недостига аналитот, и кога една постапка не е доволно дискриминирачка, треба да се користи дополнителна процедура (I Q2(R2), усвоен 2023-11-01, поправена 2023-11-30). Барањето за специфичност е тест за способност, нема број на тестови.
Референтната стандардна практика за пептидниот идентитет конвергира во иста насока без фиксирање на број: повеќе ортогонални техники обично се користат за да се потврди хемиската структура и хемискиот идентитет, вклучувајќи време на задржување на HPLC, NMR, МС и хирално тестирање, и мултилабораториски студии користат NMR, мапирање на пептиди, HPLC и анализа на аминокиселини (Фармацевтско истражување, 2023). HPLC идентитетот во таа практика се потпира на споредба на времето на задржување во однос на референтниот стандард, поради што времето на задржување без стандард не е идентитетски резултат.
Мапирањето од метод до прашање кое Добавувач на големо со пептиди произлегува од овие извори:
|
Прашање за идентитетот |
Техника која одговара на тоа |
Што не одговара |
|---|---|---|
|
Дали е точна недопрената маса? |
LC-MS или MALDI-TOF недопрена маса |
Секвенца, позициони или стереохемиски карактеристики |
|
Дали е точна низата? |
MS/MS со покриеност на секвенца, или мапирање на пептиди |
Лабилни модификации, делумно покриени празнини |
|
Каде е модификацијата или етикетата? |
MS/MS фрагменти кои одредуваат локација со наведен праг на локализација |
Дали страницата е функционално релевантна Мелитин |
|
Дали стереохемијата е точна? |
Потврдена хирална анализа; обичната анализа на составот на аминокиселините сама по себе не ја утврдува стереохемијата |
Позиција на модификација |
|
Дали е истиот материјал како стандардниот? Прилагодено пептид на големо |
Време на задржување на HPLC во однос на референтниот стандард |
Сè што самиот стандард не го утврдува |
Навиката за преглед на COA за одржување на секој заклучок со неговиот метод е практичната верзија на оваа табела: хроматографската чистота ја опишува хроматографската хомогеност и не го утврдува независно хемискиот идентитет, непроменета маса сама по себе не може да ја утврди секоја низа, позиционална или стереохемиска карактеристика, а идентитетот и чистотата треба да се пријават посебно и да се приложат на методите што ги поддржуваат (Вектор Е Лаб, 2026-09-28).
Што треба да се запише пред стекнувањето за барањето за идентитет да биде одбранливо?
Записот треба да биде доволно целосен за некој друг да може повторно да го изврши истото или слично пребарување на истиот или на друг мотор. Форматот за размена што го носи протоколот за пребарување бара од SpectrumIdentificationProtocol да декларира тип на пребарување како што е бодување на ниво на пептид или бодување за локализација на модификација, бара пребарувачите да бидат претставени во списокот на софтвер, и е дизајниран токму за таа репродуктивност (mzIdentML 1.3.0, јуни 2024).
Рекордот пред стекнувањето, собрани од стандардите за известување погоре:
-
Стратегија за селекција и нејзините параметри. Врвна N вредност, прозорец за изолација, динамично времетраење на исклучувањето, и дали списокот со исклучување се пренесува меѓу вртењата.
-
Толеранции. Толеранција на маса на претходник и фрагменти, наведени како бројки. На 2016 користена студија 10 ppm и 0.5 И (Крејмер и сор., J Proteome Res, 2016); точноста на ниво на инструмент со која методот треба да се совпадне е подолу 3 ppm RMS заврши 24 h со надворешна калибрација и подолу 1 ppm RMS со внатрешна калибрација на актуелна Orbitrap платформа (Термо Фишер спецификациски лист, тековно објавен лист со продавачот).
-
Пребарувач и верзија, база на податоци и верзија со број на записи, и методот на проценка на FDR. Пребарувањето со цел-мамка е прифатен начин да се разликуваат точните од неточните идентификации, и затоа што повеќето пребарувачи враќаат резултати дури и за неспоредливи спектри, стапките на грешка мора да се проценат од распределбата на бодовите (Илијас & Гиги, Природа методи, 2007). Довербата по пептид доаѓа од веројатен модел кој ја пресметува веројатноста дека секоја задача е точна, овозможување филтрирање со предвидливи стапки на грешки (Келер и сор., Анален Хем, 2002).
-
Методот за доделување локација и неговиот праг, со означени спектри за секој пептид каде што е пријавено место за модификација.
-
Реплицирајте ја структурата. Број на реплики, и дали се биолошки, процесна или техничка.
-
Идентификаторот на архивата. PXD идентификаторите се постојани, единствен и задолжителен како главен идентификатор за првично поднесените збирки на податоци, со метаподатоци плус необработени и обработени датотеки депонирани заедно, и RPXD идентификатори за повторно анализирани сетови на податоци (Конзорциумот ProteomeXchange, Истражување за нуклеински киселини, 2026-01-06).
Правилото за одлука, се применува пред стекнувањето: ако не можете да ја запишете стратегијата за селекција, толеранциите, параметрите за пребарување, прагот на локализација и репликативната структура однапред, тврдењето за идентитет нема да може да се одбрани потоа. Секое од тие полиња е одлука, и секој од нив е поевтино да се направи пред трчање отколку да се реконструира после него.
Најчесто поставувани прашања
Дали ниското техничко-репликативно преклопување значи дека мојот метод е лош?
Не мора. Конвенционалниот DDA ги избира само најинтензивните прекурсори во секој циклус, толку ниско преклопување помеѓу репликите е очекувано однесување при земање примероци наместо неуспех на репродуктивност (Таб и сор., J Proteome Res, 2010). Прашањето што треба да се постави е што требаше да покаже репликаниот дизајн.
Може ли да го цитирам 29% фигура како општ репер?
бр. Доаѓа од еден 2016 студија на LTQ Orbitrap XL со дигест HeLa и a 120 мин градиент (Крејмер и сор., J Proteome Res, 2016). Цитирај го со тој опсег во прилог, или наведете го механизмот квалитативно.
Која низа покриеност треба да ја ставам во спецификацијата?
Не постои минимум поддржан од регулатор. Наведете го прагот што сте го примениле, потврдете дека покриеноста ги вклучува остатоците што ја носат модификацијата или етикетата, и пријавете ги параметрите за пребарување што му дозволуваат на рецензентот да ја репродуцира пресметката.
Дали е недопрена маса доволно за да се потврди идентитетот?
бр. Меѓу пептидите се разликуваат по еден, две или три аминокиселини, 10%, 29% и 53% имаат масовно идентични изомери (Тој и сор., J Proteome Res, 2004). Масата е еден ортогонален метод, не е целосно тврдење за идентитет.
Дали ми требаат точно два ортогонални методи?
На 2025 Европското упатство препорачува најмалку два за идентификација на синтетички пептиди (ЕМА, ефективни 2026-06-01), додека ICH Q2(R2) го врамува барањето како засновано на специфичност, а не како фиксно броење (Јас, 2023). Комбинацијата треба недвосмислено да ја потврди низата; од тоа произлегува бројката.
Заклучок
Барањето за идентитет е изградено пред стекнувањето, не после тоа. Стратегијата за избор на претходници одлучува кои пептиди ќе бидат земени во мостра, реплицираниот дизајн одлучува дали преклопувањето е информативно или случајно, известувањето за покривање одлучува дали модифицираниот остаток е всушност во доказот, и ортогоналната карактеризација одлучува дали тврдењето ќе преживее пред рецензент кој знае дека масата сама ги остава изомерите нерешени.
Следниот чекор е рекорд пред стекнување: стратегија за селекција, толеранции, параметри за пребарување, праг на локализација, реплика на структура и идентификатор на архива, запишано и контролирано со верзијата пред првото инјектирање. Ако некое поле недостасува, поправете го пред извршувањето наместо во одговорот на рецензентот.
За тимови кои го споредуваат опсегот на услугата за прилагодено, модифицирани и означени пептиди, побарајте понуда која ги наведува аналитичките параметри погоре, а не само бројка за чистота.
Наведените аналитички стандарди и споредби на методи се независни објавени извори.*